华为发布 Atlas 960E 超节点:业界首个 NPO 光互联,4096 卡 8 EFLOPS
超节点:把整个集群当成一台机器来设计
9 月 17 日,华为全联接大会 2026 在上海开幕。轮值董事长 David Wang 在主题演讲里发布了 Atlas 960E 超节点,官方定位是「业界首个基于 NPO(近封装光学)的超节点」,目标是支撑十万亿参数级模型的训练与推理。华为同时重申了自己的 AI 战略:以算力为中心、靠系统与架构创新立足,并通过开源开放建立生态。
理解这场发布,要先理解「超节点」在华为语境里的含义:它不是一台服务器,也不是一颗芯片,而是把大量 NPU 通过统一协议以点对点方式互联,支持跨物理服务器的内存访问,近距用铜、远距用光,最终让整个集群在软件看来更像一台计算机。这条路线的终点是「超集群」——用超节点堆出十万卡级算力。
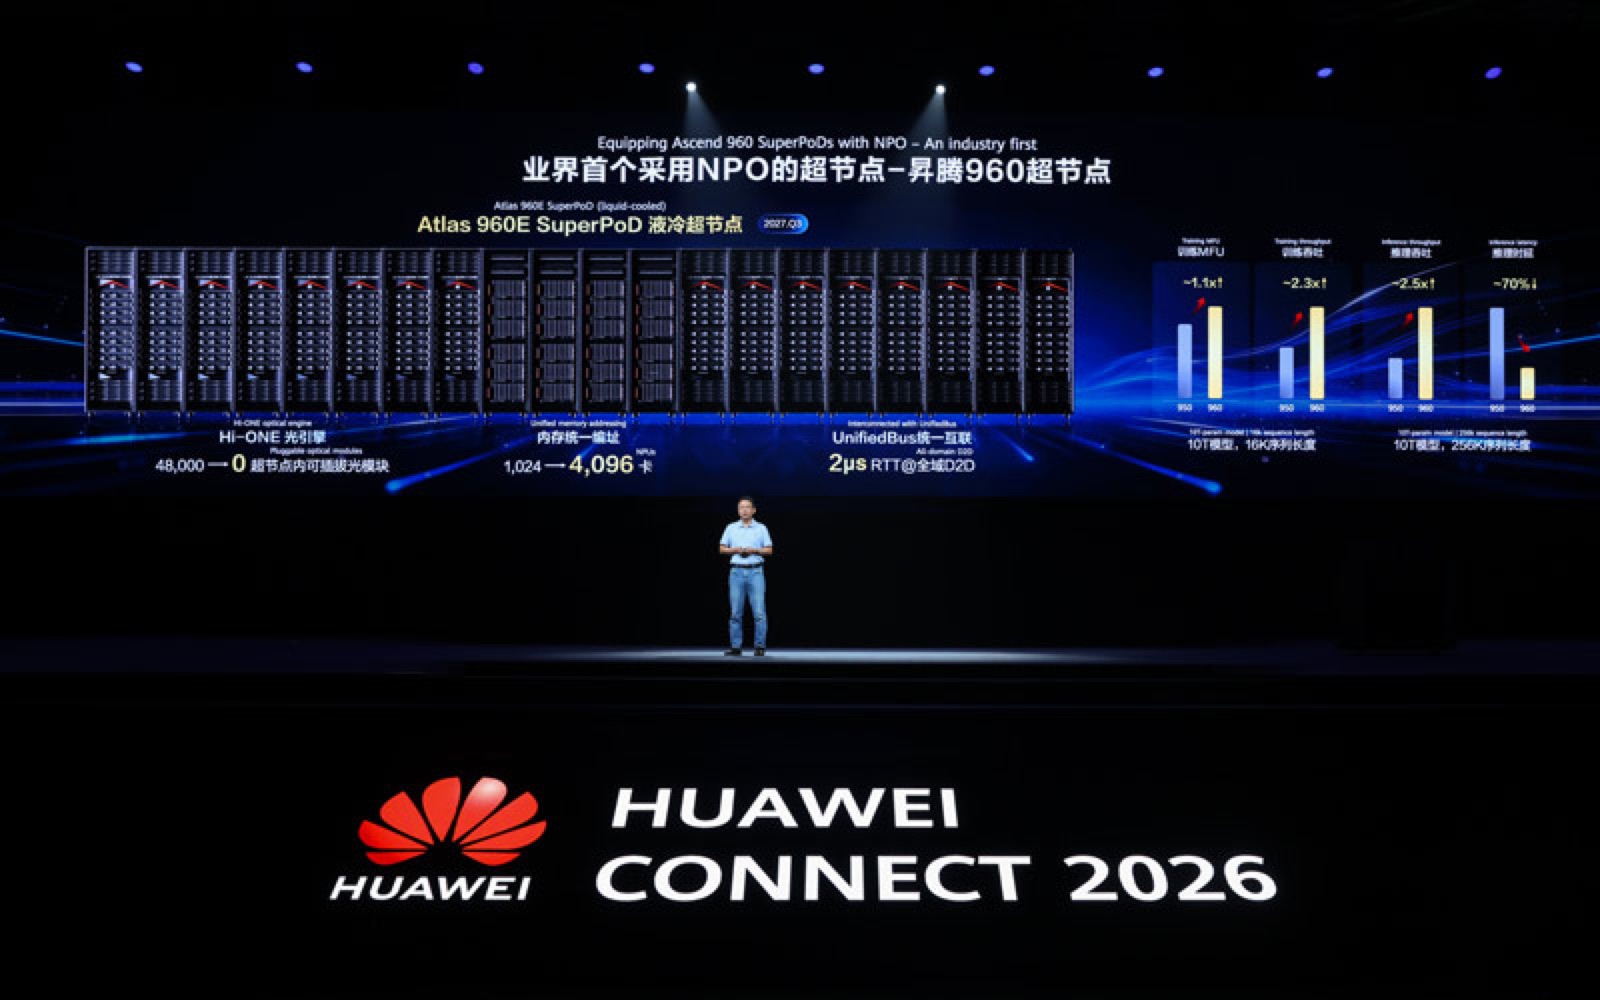
Atlas 960E 的具体参数是:单节点最多 4096 颗 NPU,FP8 精度下 8 EFLOPS,FP4 精度下 16 EFLOPS;采用正交架构与全液冷设计;借助 UnifiedBus 实现内存统一编址。华为表示,这样的规模是面向十万亿参数模型准备的。
互联层面,华为用了自研的统一总线 UnifiedBus,由它承载内存统一编址,让单个超节点扩展到 4096 颗 NPU。这也是「超节点」与「一堆用网线连起来的服务器」的根本区别:前者让跨服务器的内存访问发生在同一个协议之内,软件不必为规模变化改写模型。相关性能指标都来自华为的发布材料,尚无第三方独立验证。
Hi-ONE:5500 个光引擎替掉 48000 个光模块
光是这套系统里最显眼的变量。传统做法是给每一颗 NPU 配一整套 800G 光模块,规模一上来,模块数量、功耗与故障点都会同步膨胀。华为给出的替代方案是把光引擎挪到更靠近交换芯片的位置,缩短电信号走线,用少量引擎替代大量模块。
要理解 NPO 为什么值得单独讲,得看光互联在超大规模集群里的位置。当节点数从几百涨到几千,电互联的距离与功耗会迅速变得不可承受,业界因此不断把光电转换点向交换芯片靠近:从可插拔光模块,到近封装光学,再到把光引擎与芯片共封装,这条路线上的每一步都在换取更高的带宽密度与更低的每比特功耗。华为这次把重心放在「近封装」这一档,并强调相关产品已经进入量产。
这台超节点里塞进了 5500 个 Hi-ONE 光引擎。华为称,如果按传统方案连接同样数量的 NPU,需要 48000 个 800G 光模块;换成 Hi-ONE 之后,功耗降低超过 550 千瓦,系统无故障运行时间翻倍,可用度达到 99.8%。Hi-ONE 全称 High-density Optical-interconnect-Node Engine,单引擎传输容量 7.2 Tbit/s,华为称其是业界首个量产、容量最大的 NPO 产品,也是目前唯一内置光源的 NPO。
「内置光源」这几个字值得多看一眼。光互联的可靠性瓶颈常常不在引擎本身,而在外部激光源的耦合与寿命管理;把光源做进引擎,理论上能简化系统结构、减少外部光纤与连接器,但同时对封装与散热提出更高要求。华为在发布材料里强调,Hi-ONE 做了光学、机械、电气、电磁与热的多物理场协同设计。
不止 AI:泰山 950 与上下文存储
华为把这套架构从 AI 推到了通用计算。升级后的泰山 950 超节点同样基于 UnifiedBus 全光互联,最多支持 4096 个节点,统一内存池容量可达 256 TB。官方给出三个受益场景:更高密度的智能体沙箱、更快的沙箱启动速度,以及更好的智能体向量检索性能。
存储侧,华为发布了 OceanStor M900,一款基于 UnifiedBus 的上下文存储集群,支持一跳直达访问,为 L3.5 层提供 PB 级 KV cache 容量。所谓 L3.5,指向的是大模型推理中那个既不属于显存、也不属于传统主存的中间层——KV cache 随着对话变长呈指数增长,把它放在哪里,直接决定长上下文服务的成本。
从 51.2 万卡到百万卡,以及开源的 CANN
超节点之外是超集群。华为给出的扩展路径是:用 UnifiedBus 网络或 RoCE 把多台 Atlas 960E 超节点连接起来构成超级集群;采用两级四平面 Clos 架构时,最多可互联 51.2 万颗 NPU;再叠加多轨拓扑,则可支持到 100 万颗 NPU。
华为同时把「开源开放」列为战略的一部分。发布中明确提到 CANN 已完成开源开放,进入社区驱动的持续开发阶段,官方说法是从「可用」走向「好用」,并称这是昇腾生态的新拐点。对使用者来说,这意味着软件栈的迭代节奏不再完全掌握在单一厂商手里,而这一点恰恰是国产算力能否被外部团队真正接纳的关键变量之一。
该保留的怀疑同样要说清楚。这份发布里几乎全部关键数字——8 EFLOPS、4096 卡、99.8% 可用度、百万卡集群——都出自华为自己的材料,属于产品规划与设计目标,不等于已经在客户现场跑满的实测成绩。超节点路线本身也还在演进中,光引擎的良率、统一编址的软件适配、集群级运维,都是需要时间才能验证的部分。
不过有一点值得放在更大的背景里看:这一代竞争的重心,正在从「单颗芯片的峰值算力」转向「系统、互联与软件生态」。光互联、统一编址、液冷、集群规模,这些词过去属于基础设施工程;如今它们直接决定一个大模型能不能被训练出来、一次推理要花多少钱。华为选择的路是先做好光和系统,再用开源生态拉开发者——这条路能不能走通,最终不看发布会上的 EFLOPS,而看客户机房里那 99.8% 的可用度是否真的持续成立。