SK 海力士在 OCP 峰会给出「内存中心」答案:CXL 内存池、MARS 机架与 CMM-Ax
内存墙与一个判断
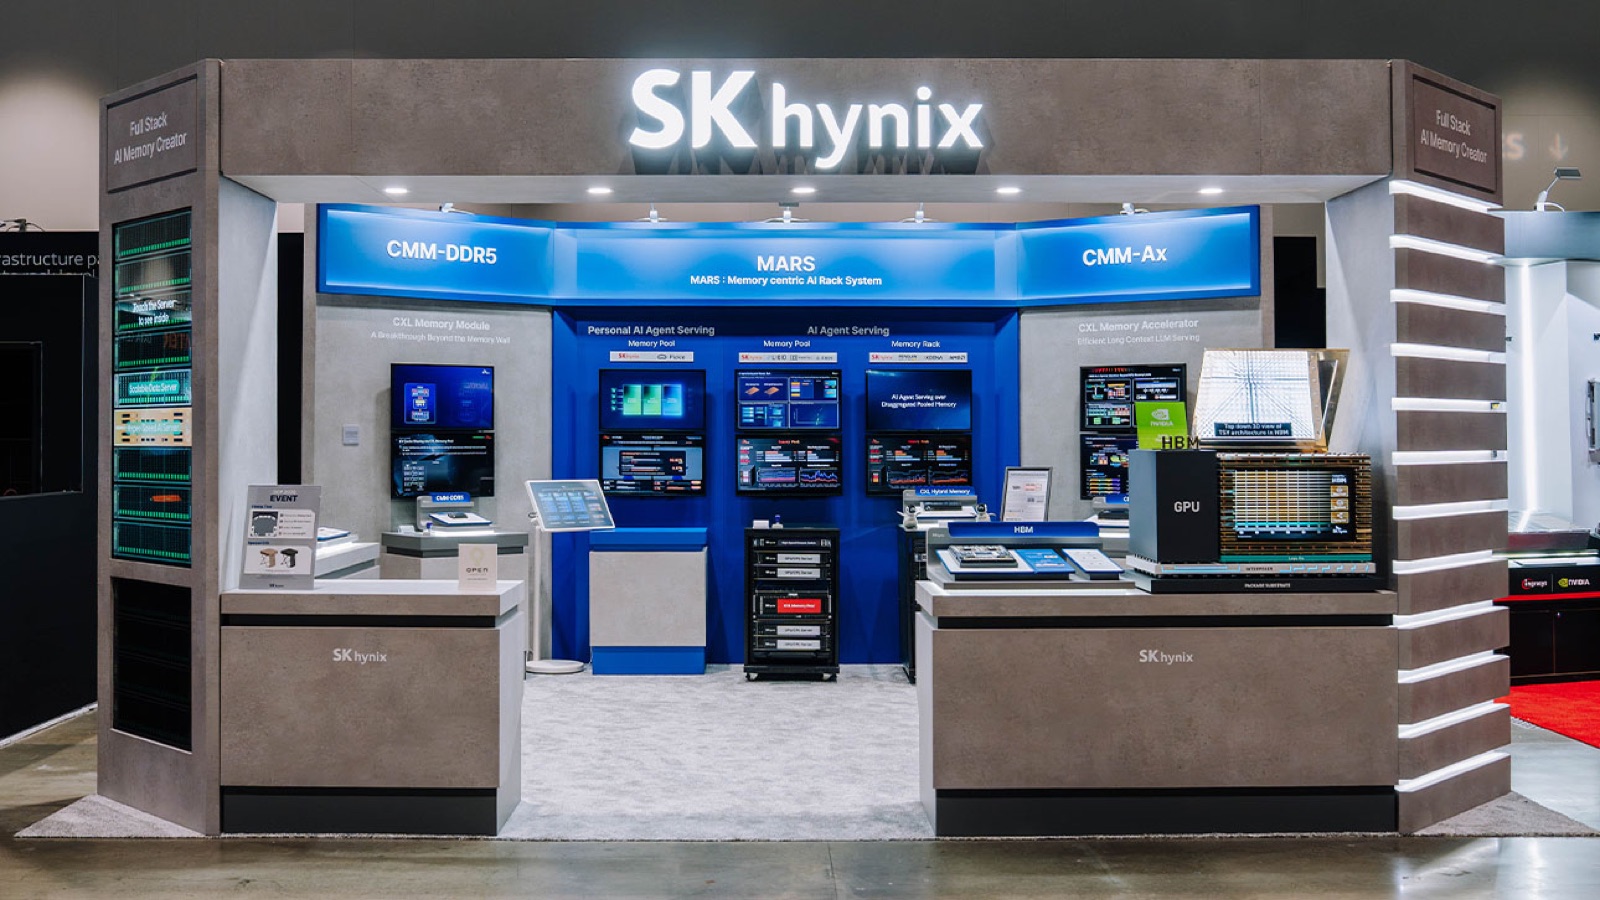
10 月 12 日至 15 日,OCP Global Summit 2026 在加州圣何塞举行。OCP 是面向数据中心硬件设计与规范共享、标准化的技术会议,今年的核心议题之一,正是支撑 AI 继续前进的基础设施技术。SK 海力士把展台的一大块留给了「系统级演示」——不是把芯片摆在玻璃柜里,而是把下一代内存方案装进真实系统里跑起来。
这家公司给出的判断只有一句话:以内存为中心的服务器系统是未来。背景是 AI 处理的数据量爆炸式增长,数据瓶颈成为新的难题:以 CPU 和 GPU 为中心的既有架构撞上了「内存墙」,功耗也在同步飙升。SK 海力士的答案是让内存在系统里占据核心位置,而不是继续当配角。
把内存做成池子:CMM-DDR5 与 CXL
演示区从左到右排开三套方案:CMM-DDR5、MARS 与 CMM-Ax。CMM 即 CXL Memory Module(CXL 内存模块),思路是让多台服务器共享一个内存池、按需取用,从而提高资源利用率。CXL 本身是基于 PCIe 的互联标准,用来把 CPU、GPU 与内存高效连在一起,并提供内存池化能力。
这次展出的是第二代 CMM-DDR5,容量 256 GB,基于 CXL 3.2,面向 AI 负载优化。相比上一代,带宽提升一倍以上(80 GB/s),能效改善约 30%,并应用了 CXL Pooled 功能。对数据密集、负载很高的工作负载来说,这类产品被寄望于缓解内存瓶颈。
这项技术不是第一次露面。SK 海力士在去年 9 月与 NAVER Cloud 签署业务协议,此后一直围绕 CXL 内存方案解决云上 AI 服务的瓶颈。本次演示中,公司给出了概念验证(PoC)级别的结果:在智能体 AI 环境里共享 KV cache,以及在全模态服务 OmniServe 中共享 embedding,是否真的可行。所谓 KV cache,是大模型智能体生成文本时缓存已算结果的那块临时内存,对话越长、任务越多,它增长得越快,因此如何存与取,直接影响智能体的表现。
MARS:以内存为核心的一柜服务器
MARS 全称 Memory Centric AI Rack System,直译是「以内存为核心的 AI 机架系统」。它的做法是把多家合作伙伴的方案集成进同一个机架,让内存处在核心位置。这次 SK 海力士与伙伴一起做了三个演示。
第一个是与 Arcee、Liqid、Marvell 合作的智能体 AI 服务演示:用池化内存把多台服务器和多颗 GPU 连起来,证明基于 CXL 池化内存传输或复用 KV cache,比传统依赖网络通信的方式显著提升系统性能。
第二个是与 AMD、Penguin、Xcena、Arcee 合作的演示:验证一套同时使用 CXL 内存与 CXL 混合内存(DRAM 加 SSD)的内存机架,能否高效存放并快速复用持续产生的大规模 KV cache。演示中展示了两项能力:根据此前的对话与任务历史预测接下来会用到哪些 KV cache,以及把这些 KV cache 提前加载进 DRAM 以加快处理。把完整 KV cache 存到 SSD 上,则同时兼顾了读取速度与容量。
第三个演示与个人 AI 智能体服务商 Pickle 合作,用池化内存降低服务响应延迟。个人智能体要串联多个 AI 模型,SK 海力士证明基于池化内存的流式传输可以加速这些模型之间的数据搬运,让最终结果更快到达用户。
负责内存系统研究的副总裁 Hosik Kim 在演讲中把话讲得很直白:这套系统「通过下一代 CXL 技术连接 CPU 与 GPU,实现机架级内存池化与动态零拷贝数据共享」,结构上显著提升高负载工作负载的数据搬运速度。他给出的三个受益场景是:协作型智能体的 KV cache 复用效率、个人智能体服务中多模态全模态模型的响应速度,以及大规模图神经网络训练里的不规则内存访问问题。
CMM-Ax:把计算搬进内存,以及 HBM 与 HBF 两条产品线
第三套方案 CMM-Ax 走的是另一条路:把计算能力与内存结合起来,在内存内部直接完成计算,不必把数据搬来搬去,从而降低数据中心的功耗与成本负担。展台上,SK 海力士用一套名为「高效长上下文大模型服务」的下一代 AI 推理系统演示了它,证明 CMM-Ax 能有效加速传统 GPU 系统难以处理的长上下文负载。支撑这项成果的研究也因技术价值被计算机体系结构领域最负盛名的学术会议 MICRO 2026 收录。
围绕这一点还有更细的工程分享。AI 系统基础设施团队负责人 Jongryool Kim 讲了基于共享内存提升智能体服务性能的技术:token 共享可以加速 CPU 侧的 token 化,KV cache 共享则改善响应速度与资源效率;他还提出可把 token 化与实时 KV cache 重要性分析卸载到带计算能力的共享内存上。同场的 Younghoon Min 与宾夕法尼亚州立大学教授 Kiwan Maeng 讲了如何用带计算的存储让差分隐私训练更高效。AI 平台软件团队的技术负责人 Juhee Lee 则分享了「把存储当作大模型服务的一个性能层级」。另一场专题讨论的主题,是多公司软件框架与 API 在 PIM 与 PNM 上的整合与标准化需求。
展台的另一半是产品线。eSSD 按形态分列:高性能的 PS1010 U.2、正在连续开发中的高性能 PS1110 E3.S 与大容量 PS1101 E3.S,以及支持直触液冷(DLC)的 PEB210 E1.S 与 PEB210 M.2 2280。服务器 DRAM 一侧,容量从面向 AI 负载、官方称为业界最大容量的 256 GB 3DS RDIMM,延伸到 96 GB 与 64 GB;此外还有 128 GB 的 DDR5 MRDIMM,以及用新形态改善功耗与空间效率的 192 GB SOCAMM2。
HBM 展区摆在正中:一侧是 NVIDIA Vera Rubin 超级芯片的模型,观众可以自己把 HBM4 与 SOCAMM2 装到服务器模型上;另一侧是放大一百万倍的 HBM 模型,配一块屏幕讲解 TSV 与 Advanced MR-MUF 这两项核心技术,中间则陈列了 HBM4E、HBM4 与 HBM3 实物,让人一眼看出代际演进。官方给出的代际顺序是 HBM、HBM2、HBM2E、HBM3、HBM3E、HBM4、HBM4E;Advanced MR-MUF 被描述为可以做到翘曲控制,把比常规薄 40% 的芯片堆叠起来而不弯曲,同时改善散热。此外,SK 海力士还介绍了 HBF(High Bandwidth Flash):像 HBM 一样使用 TSV 技术,把传统存储的大容量与高带宽结合起来;其内部仿真显示,需要快速响应的场景适合用 HBM,需要大容量、服务众多用户的场景则适合 HBF。公司对这次峰会的总结是:今年的意义在于能展示下一代内存方案在真实系统里如何工作。