天数智芯把 144 颗 GPU 装进一个机柜:国产算力开始比整柜系统
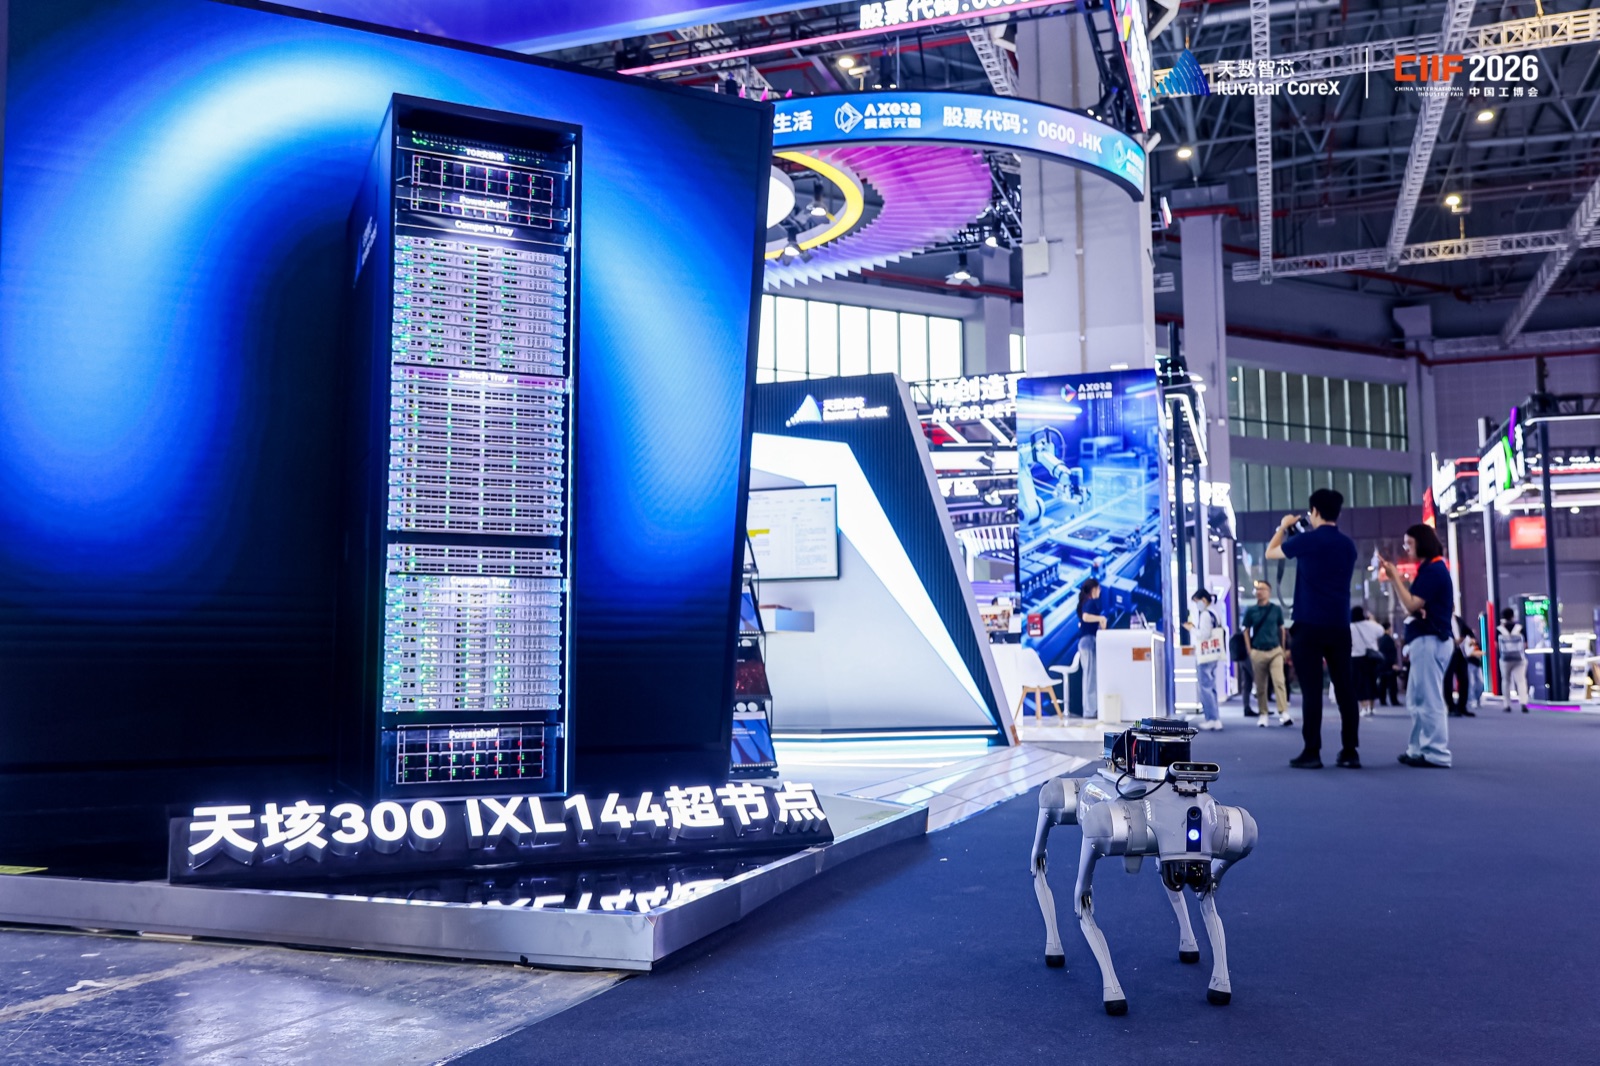
144 颗 GPU 与 18 颗 CPU,装进一个机柜
10 月 12 日,在上海举行的 2026 中国国际工业博览会上,天数智芯展出了公司首个系统化超节点方案——天垓300 IXL144。据公司介绍,这套方案在单个机柜内集成 144 颗图形处理器(GPU)与 18 颗中央处理器(CPU),把过去需要跨多台服务器、多个机柜组织的算力收进了一个整机柜。
把时间线连起来看,这一步的分量更清楚:今年 1 月,公司公布四代架构路线图;7 月在世界人工智能大会上发布天垓300 加速卡;10 月工博会拿出基于天垓300 的整柜方案。官方叙述的落点也在这条线上——旗舰 GPU 的能力正在从单芯片延伸到整机柜,并在真实机房中持续迭代。
公司在发布现场的表述是,超节点不是单一产品,而是一项系统工程,最终比拼的是系统经济效能。IXL144 是这套系统化超节点方案中的第一款产品,后续面向不同算力规模、不同机房条件的完整产品会陆续发布。这段话实际上界定了竞争维度的变化:比的不再只是单卡峰值算力,而是整柜能提供多少有效算力、需要付出多少改造代价。
还有一个容易被忽略的前提:据公司介绍,天垓系列已经实现万卡级规模的部署。单柜方案是建立在既有出货与运维经验之上的,而不是从零开始的设计——对买方而言,这决定了它属于已有产品线的延伸,还是全新的赌注。
什么是超节点,为什么现在都在做
所谓超节点,本质是把几十到几百颗加速器通过高带宽、低时延的互联组织成一个更大的算力域,让跨卡的通信尽量接近片间直连的水平。大模型训练时,参数、梯度与激活值需要在卡之间高频交换,通信开销往往吃掉相当一部分算力;把交换做得更快、更短路径,等于把同一批芯片的有效产出抬上去。
这也解释了超节点与传统集群(scale-out 扩展)的区别。后者的做法是把多台服务器用网络连起来,通信要穿过网络栈与交换机,延迟与带宽成本都更高;前者则在机柜内部建立高带宽互联,把「一个任务最多能并行铺在多少张卡上」的上限整体抬高。两者并非替代关系,但在超大模型训练里,机柜内的那一段往往决定效率的上限。
国内厂商在这个方向上的紧迫感,还来自另一重现实:当单卡在制程与内存带宽上受到客观条件限制时,用机柜密度、互联拓扑与软件栈的效率去补足单卡的差距,是一条更现实的路径。「超节点元年」的说法正来自这种思路的转变——从追单点指标,转向追系统产出。
需求侧的变化同样直接。报道引用的 IDC 报告显示,智能体(Agent)进一步推高算力需求,2026 年中国智能算力规模预计达到 2576.5 EFLOPS,同比增长 87.9%;在这样的增速下,超节点开始从技术验证走向规模部署。这一点对理解这次展示的时点很关键:它不是一次孤立的技术演示,而是对应着采购行为的变化。
客户要算的三笔账
报道把从技术验证走向规模采购的门槛总结成三笔账。第一笔是软件账:已有模型和代码是否需要推倒重写。第二笔是机房账:是否要为整机柜专门改造供电、承重与散热,甚至新建机房。第三笔是运行账:每百万有效词元(Token)的成本能否下降,以及算力能否按需扩展而不闲置。三笔账加在一起,才是「买不买」的真正判据。
天数智芯给出的应对方向是三条同时做到:集成密度更高、对现有机房更友好、对已有代码更兼容。落到产品上,单机柜形态贴近常规机柜标准;采用通用 GPU 架构、兼容主流生态以降低迁移上线成本;通过整柜互联让 144 颗 GPU 协同工作。这三条对应上述三笔账,逻辑是自洽的——难点在于能否同时成立。
先看软件账。把一个模型从一套生态搬到另一套生态,成本并不只在训练代码本身,还包括算子库覆盖、分布式训练框架的适配、推理服务与调优工具链,以及工程师的学习曲线。这些开销不出现在采购合同里,却往往决定项目能否按期上线,这也是「通用架构、兼容主流生态」会被当成核心卖点的原因。
再看机房账。高密度机柜带来的不是多几根线的问题:整柜功率密度上升会逼近风冷极限,需要液冷方案;重量分布影响楼板承重;配电、管路与监控往往要按层改造。对已建成的数据中心来说,这些工程量可能超过设备本身的价值,「不用新建机房」因此成为可以量化的收益。
最后是运行账。每百万有效词元的成本由能耗、设备折旧、利用率和软件栈效率共同决定:密度与互联改善能摊薄通信开销和闲置损失,但最终数字取决于具体模型、并发规模、实际利用率与当地电价。因此业内常见的成本对比通常在给定条件下成立,把它当成普遍结论需要额外小心。
这一轮竞争比的是什么
把这次的展示放回语境,需要分清它是什么、不是什么。报道的措辞是「亮相」与「首个系统化超节点方案」,属于首次公开的方案展示,而不是宣布已经完成大规模商业交付。单柜具体密度、互联时延、实测性能、整柜功耗与散热规格、客户订单等关键参数,尚未由公司以完整白皮书或测试报告的形式披露,评价「密度最高」「成本最低」一类比较性表述时,先要看比较口径。
但方向是清楚的。国产算力的竞争重点正在从单卡参数转向整柜密度、芯片互联、软件栈与整机柜的系统经济性;对买方而言,真正决定成败的问题也从来不是峰值算力榜单,而是模型要改多少、机房要动多少、每百万有效词元要花多少。谁能把这三笔账同时算平,谁才拿得到规模订单。