Meta 在 OCP 2026 亮出 102.4T 交换与以太网 scale-up:一柜 72 颗加速器
102.4T 一代与液冷网络机架
10 月 12 日,Meta 在 2026 年开放计算项目全球峰会(OCP Global Summit)上公布了一批网络基础设施成果,摆在最前面的两件是硬件:公司首款液冷网络机架 IcePack,以及工作速率 102.4 Tbps 的交换刀片 IceCube。
这些硬件的服务对象是 Meta 自己的模型与智能体:这次发布里点名的工作负载包括 Muse Wonder 与 Muse Spark 两个模型,以及面向所有人的个人 AI 智能体 Muse。换句话说,这一代网络不是为了跑分,而是为了让自家越来越大的训练与推理任务待在同一个集群里。Meta 也把话说得很清楚:邀请工程师、芯片厂商、系统集成商与运营商一起,在 OCP 社区里解决开放、高效、可持续的 AI 基础设施问题。
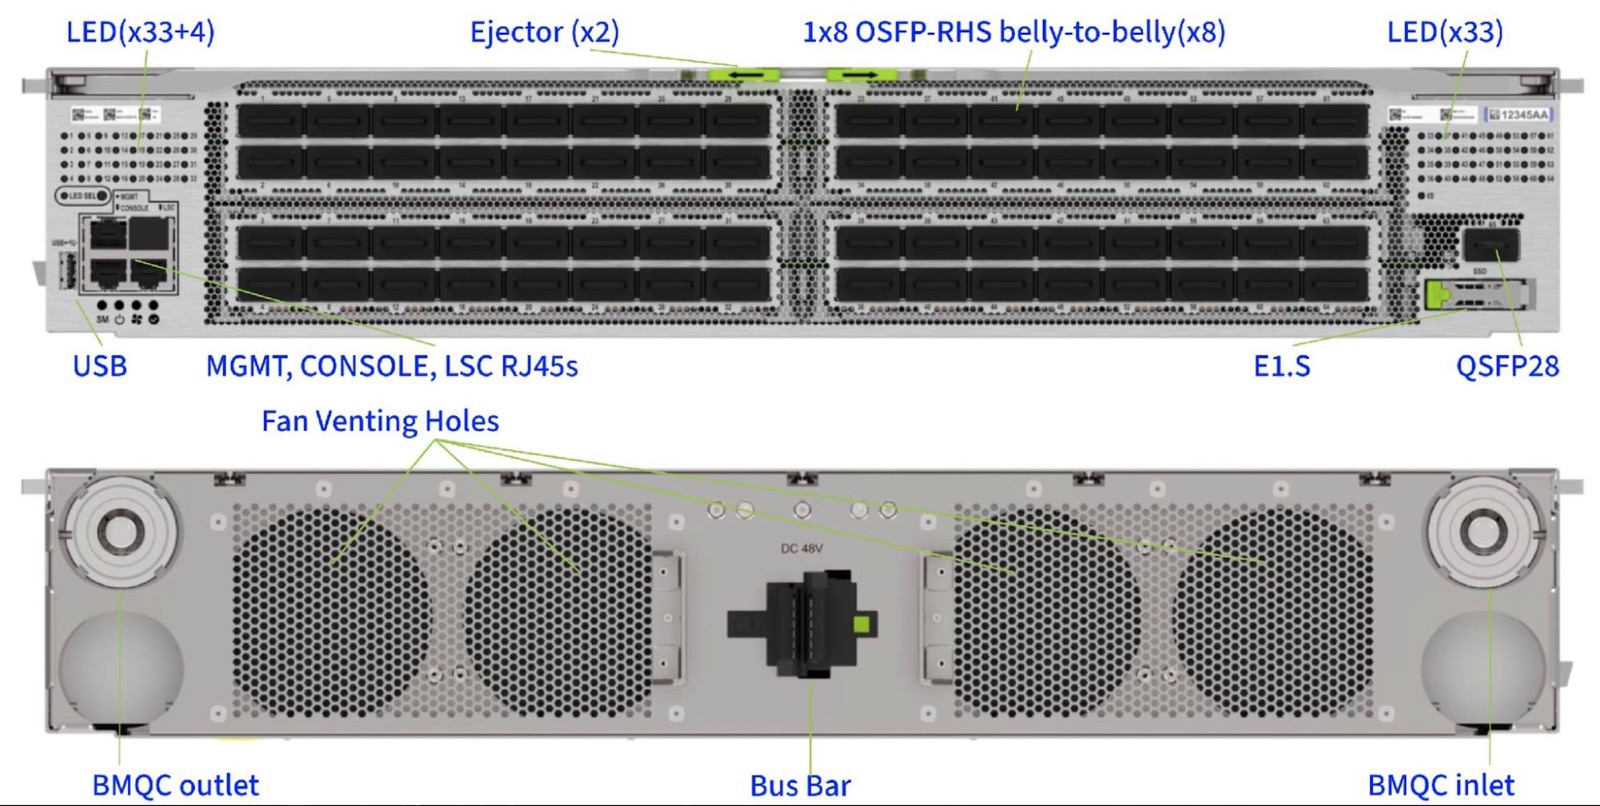
IcePack 基于 OCP 的 ORV3-HPRv1 机架标准,是 Meta 第一代液冷网络机架。机架里插的是 IceCube 交换刀片:102.4 Tbps 交换容量,提供 128 个 800G 端口的无阻塞交换能力。IceCube 有两个版本,分别搭载博通的 Tomahawk6C 交换 ASIC 与 NVIDIA 的 Spectrum-6 交换 ASIC,两者都运行 Meta 开源的 FBOSS 网络操作系统,并通过 OCP 的 SAI(交换机抽象接口)对接硬件。
这一代相比上一代 51.2T 平台带宽翻倍,同时满足了下一代 AI 数据中心对散热密度的要求。这也是「液冷」出现在网络设备上的原因:当集群走向吉瓦级,交换机必须在越来越紧的功耗与散热包络里提供成倍的带宽,单纯的风冷已经不够用。
FPF:每颗 GPU 拉八条链路到八台交换机
更有意思的变化发生在拓扑上。Meta 这次介绍了 Flattened Planar Fabric(FPF),一种多平面后端组网方式;用 Meta 的话说,它从根本上改变了 GPU 接入网络的方式,也改变了这张网的控制面。
具体做法是:每颗 GPU 用八条独立的 100G 链路,分别接到八台不同的交换机上——每个平面一台。这取代了传统的单平面上行架构,带来四个好处:相比单平面拓扑可以支撑更大的无阻塞 GPU 集群;把原来的三级 Clos 压平成两级 Clos,减少一层交换机,从而减少跳数、降低延迟与基础设施成本;负载均衡从交换机前移到网卡,由网卡硬件把每个报文喷洒到八个平面上;控制面同时覆盖交换机与主机,主机据此把流量从故障平面上引开。
这项工作与 NVIDIA 紧密合作完成,跑在 Meta 自己的基础设施里,借用了 NVIDIA Spectrum-X 的多平面创新,以确保在各类故障与运维生命周期场景下仍有高性能。Meta 还把经验分享给云伙伴,推动多平面组网在合作伙伴侧落地。这不只是技术问题:Meta 的算力缺口无法单靠自建机房填满,土建以年计、需求变化以月计,因此必须同时使用租赁设施与公有云容量。而要让公有云里的 GPU 和自建机房里的 GPU 表现一致,网络必须被标准化。
跨区域的一层是 BAG(后端聚合)。它是以太网为基础的集中式超级脊,把多个脊层组网连成跨越楼宇、园区与区域的巨型集群,工作在拍比特量级——两个区域之间的 BAG 互联容量可达每秒数十拍比特。Meta 给出的规模坐标是:Prometheus 在 2026 年约 1 吉瓦,Hyperion 则向 5 吉瓦扩展。距离在这里变成设计约束:无损以太网所需的缓冲余量正比于线缆长度,链路拉到几十公里后,缓冲管理就从调参问题变成首要问题。FBOSS 的做法是在现场测量真实线缆长度——通过测量无拥塞队列上探测流量的往返距离来推导,再按测量值分配余量。
用以太网做 scale-up
scale-up 指的是机架或 pod 内加速器之间那种高带宽、超低延迟的互联,历来依赖各家私有技术。Meta 这次要证明以太网也能干这件事:它推出的是一台叫 Tahan 的以太网 scale-up 交换机,专为 Meta 自家的 MTIA 300 训练加速器设计,基于博通 51.2 Tbps 的 Tomahawk 5 ASIC,总容量 64 个 800G 端口,其中一半通过背板为加速器提供 scale-up 连接;四台 Tahan 以无阻塞拓扑互联 16 颗加速器,平均到每颗加速器是 6.4 Tbps。更关键的是,Tahan 复用了与 scale-out 网络完全相同的无损 RoCE 传输(路由化 IPv6、PFC 与为 AI 调优的 QoS),把两张网统一在 FBOSS 之下。
下一代方案已经画好:一块 216 个 400G 端口的 scale-up 刀片,基于 102.4 Tbps 的博通 Tomahawk6C,八台这样的交换机互联一柜 72 颗加速器,密度相比这一代显著提升。再往后的一代计划采用 OCP 的 ESUN(Ethernet for Scale-Up Networking)作为 scale-up 数据面。ESUN 是 Meta 去年在 OCP 内发起的倡议,参与者包括 AMD、Arista、ARM、博通、思科、HPE、Marvell、微软与 NVIDIA;1.0 版网络运营商需求基础规范已于今年早些时候发布,下一版 1.1 将处理交换机方案档位与报文间隔压缩等新特性。
OSPA 与 MetaRoCE:再往上标准化一层
Meta 还拉上微软与阿里巴巴共同牵头一项新的 OCP 倡议:Open Switch Platform Architecture(OSPA)。逻辑是:SAI 已经让交换机的数据面软件可以在不同芯片间迁移,但它下面的交换机平台层仍然是私有且碎片化的,每上一个新硬件平台都要重复数月的定制工程。OSPA 要统一的是电源管理与时序、传感器与环境控制(含散热与风扇)、硬件资产管理与设备枚举、带外硬件接口(管理网口、串口、USB、指示灯)、固件维护更新,以及平台故障诊断。
传输层方面,Meta 宣布开源 MetaRoCE 的实现。这是一个为 AI 集群网络优化的 RDMA 传输协议,提供分布式 AI 训练所需的拥塞控制与可靠性语义,专门针对大规模以太网上的集合通信流量形态设计。此外,Meta 还用 FBOSS 在区域骨干网上部署了基于 IPv6 的分段路由(SRv6),运行在基于思科 SiliconOne 的开放浅缓冲交换机平台上。
把这些拼在一起,Meta 的意图就清楚了:它想让 AI 基础设施从交换机、机架到传输协议全部建立在开放标准之上,而自己既当最大用户,也当标准的主要贡献者。这套路线能不能被更大的生态接受,还取决于其他公司是否愿意为 ESUN、OSPA 与 MetaRoCE 投入工程资源——这是标准化的老问题,也是 Meta 这次把「邀请」写进发布稿的原因。