NVIDIA「Vera Rubin」MLPerf 首秀:推理吞吐最高达 GB300 的 3.7 倍
预览提交里的三个数字
9 月 16 日,MLPerf Inference v6.1 的结果公布,NVIDIA 的下一代机架级平台 Vera Rubin NVL72 第一次出现在这份榜单上——以「预览提交」的形式。NVIDIA 在其官方博客里给出的结论很直接:这套系统在 Qwen3-VL 上的吞吐量最高达到上一代 GB300 NVL72 的 3.7 倍,在 DeepSeek-R1 上最高达到 2.5 倍。MLCommons 的推理基准历来是各家加速器同场比试的公开场地,一次「首秀即领先」的提交,等于把下一代平台的量产节奏提前亮给了客户。
需要先分清「预览提交」的含义。NVIDIA 这次只选了两个模型参赛:DeepSeek-R1 与 Qwen3-VL,并明确说这是预览结果,成绩取自 mlcommons.org 上公布的条目。它没有覆盖 MLPerf 推理套件的全部负载,因此 3.7 倍与 2.5 倍是真实测得的数字,但它描述的是一部分场景,而不是整张成绩单;NVIDIA 自己也把「随软件优化继续提升」写进了结论。图表下方注明了数据出处:结果取自 9 月 16 日 mlcommons.org 上公开的条目,编号为 6.1-0106 与 6.1-0074。
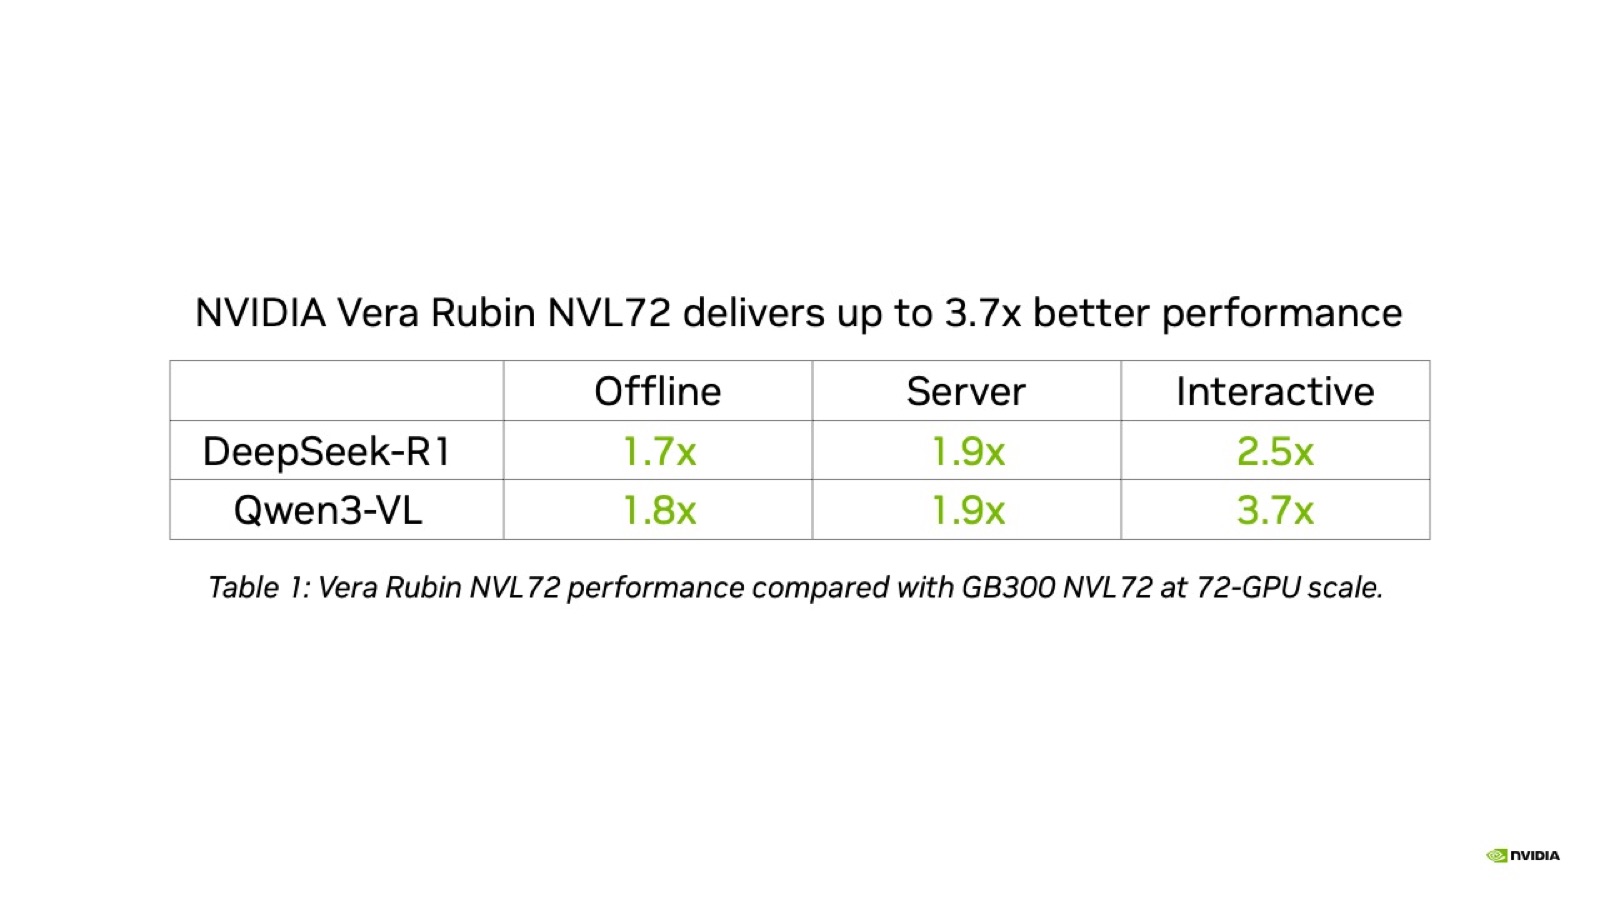
具体到场景维度,差距并不均匀。官方给出的对比表显示,在 72 卡同规模下,DeepSeek-R1 的离线、服务器、交互三种场景相对 GB300 NVL72 分别是 1.7 倍、1.9 倍和 2.5 倍;Qwen3-VL 则是 1.8 倍、1.9 倍和 3.7 倍。离线场景衡量吞吐上限,交互场景衡量响应速度——越是要求低延迟的场景,新一代平台的相对优势越大。同一张表里,两个模型的最大倍数都出现在交互场景,最小值都出现在离线场景,这个分布本身也说明新平台先在延迟敏感型负载上兑现了优势。
是什么撑起了这些倍数
两个模型走的软件栈也不相同:Qwen3-VL 用的是 vLLM 加上 NVIDIA 开源的推理框架 Dynamo,DeepSeek-R1 用的是 TensorRT-LLM。NVIDIA 把成绩归因于硬件与软件的联合设计:增强的 Tensor Core 与 Transformer Engine 同时加速预填充和解码两个阶段,而 NVFP4 这类低精度格式压缩了模型权重、注意力与 KV cache 的显存占用,从而在不明显损失输出质量的前提下提高吞吐。
另一个被反复提到的技术是「分离式服务」:把预填充与解码拆到不同的资源上执行,再配合面向混合专家(MoE)层的大规模专家并行。DeepSeek-R1 与 Qwen3-VL 都属于 MoE 架构,专家并行做得好不好,直接决定这类模型能不能跑满机器。
NVIDIA 在博客里给推理算了一笔账:决定 AI 推理经济性的杠杆有三个——系统性能、扩展效率与软件迭代速度。性能高意味着每台机器产出更多 token,也就是更多收入;扩展效率高意味着加机器能换来等比例的吞吐,服务同样多用户所需的资源更少;持续优化则意味着同一批硬件能在生命周期里持续增值。
这三个杠杆对应三个具体问题:这台机器值不值得买、多买几台能不能线性变快、以及同一批机器明年还够不够用。「平台通用性」被放在这三者的底层。同一套基础设施既要跑训练也要跑推理,既要跑推荐也要跑推理型的大模型,既要处理语言也要处理视频——只有在这些负载之间自由切换,机器的利用率才能保持在高位。这也是 NVIDIA 每年更新一代平台架构的理由:硬件节奏固定下来,客户才敢按年度规划资本开支。
从 72 卡到 288 卡:99% 的扩展效率
除了新一代平台的绝对性能,这轮提交里还有一个容易被忽略的数字:GB300 NVL72 在 DeepSeek-R1 的离线场景下,从单机架 72 颗 GPU 扩到四机架 288 颗 GPU,扩展效率达到 99%。也就是说,硬件翻了四倍,吞吐量几乎线性增长。
这个数字为什么重要?因为堆 GPU 并不会自动带来成比例的吞吐。如果 GPU 数量翻倍而吞吐只涨个位数百分比,基础设施成本就会远远跑在性能回报前面。要做到近线性扩展,机架内的高速纵向互连、机架间网络与请求编排必须同步跟上。NVIDIA 给出的底气是第六代 NVLink 与 NVLink Switch:官方称其报文速率是通用以太网的 10 倍、延迟低至三分之一。NVIDIA 还提到,云服务商 Nebius 同样提交了 Vera Rubin NVL72 的预览结果并给出了不错的成绩,说明这套平台已经开始被外部纳入测试。
视频生成也出现在这轮结果里。GB300 NVL72 在 WAN 2.2 文生视频基准上做到每秒 0.65 个 720p 视频、单条 5.7 秒——相比单节点,吞吐高 9 倍、延迟低 7.5 倍。
软件时钟与硬件节奏
同一套硬件在一年之内能快多少?NVIDIA 给了一个可比的答案:在 v6.1 这轮提交中,GB300 NVL72 跑 Qwen3-VL 的成绩比 v6.0 最多提升了 1.6 倍,来源是更低的 KV cache 精度、更多的算子融合、更优的 kernel,以及 vLLM 与 Dynamo 支撑的分离式服务。
提交截止之后,优化还在继续。NVIDIA 同时披露了一些尚未经过 MLCommons 验证的提交后结果,覆盖 GPT-OSS-120B 与 DLRMv3,并称还有进一步提升。这类数字要谨慎对待——它们没有第三方审计,但仍然说明了一个趋势:在这条产品线上,软件版本带来的收益可以和一个硬件代际相当。
边缘侧同样有更新。NVIDIA 用 Jetson AGX Thor 提交了基于 TensorRT Edge-LLM 的成绩,参加的是新引入的 Edge-Agentic 基准,模型为 Qwen3.6-27B。这轮共有 19 家合作伙伴参与提交,其中八家提交的是多节点 Blackwell NVL72 系统,名单包括华硕、Azure、思科、CoreWeave、戴尔、富士通、HPE、Lambda、Nebius、Oracle 云基础设施与超微等。
还有一个指标值得一提:在 SemiAnalysis 的 AgentX 基准的预览测试中,NVIDIA 称 Vera Rubin NVL72 的性能是 GB300 NVL72 的 30 倍。该数字来自厂商自测,但指向的问题很实在——当 AI 从「一问一答」变成多步推理、规划与执行的智能体,传统吞吐基准就不再够用,MLPerf 也将引入 Endpoints 基准来标准化这类负载的测量。对买方来说,真正的判断标准仍只有一个:在自己的模型和自己的负载上,每 token 的成本降到多少。