安霸发布 X7:首款独立 AI 加速器,给存量 Arm 与 x86 设备补算力
把 AI 装进已经卖出十年、还要再用十年的设备
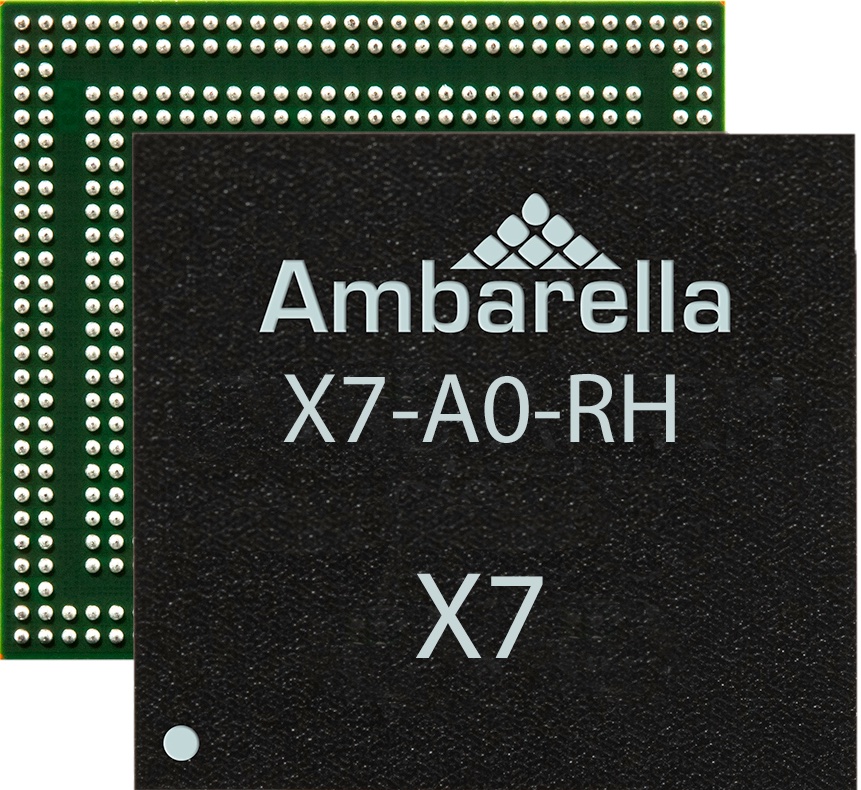
9 月 15 日,安霸(Ambarella,NASDAQ: AMBA)在圣克拉拉发布 X7 边缘 AI 加速器,这是公司第一款独立的 CVflow AI 加速芯片。它的定位不是主控,而是 Arm 与 x86 主处理器的 AI 协处理器:把它插进系统,就能增加或扩展 AI 能力,而不必重新设计底层平台。
安霸在公告里描述了一个很具体的市场:现场已经装出去的摄像头、网关和工业控制器,很多只有有限的 AI 能力,或者干脆没有,但它们还有多年的服役寿命。这些设备的所有者与运营方现在开始要求 AI 功能,而这些功能在硬件被设计出来的年代并不存在。安霸的说法是,实物世界里这样的系统有数百万台。X7 面向两类人:一类是对这批存量设备负责的 OEM 与系统集成商,另一类是在决定投入下一代重设计之前先验证新 AI 功能的团队。
这里有一个容易被忽略的经济学。工业与安防设备的更新周期通常远长于消费电子,一套装在货架、产线或路口的系统,生命周期往往超过十年。设备一旦装满墙、接好线缆、做完验收,整机替换的成本就不只是硬件本身,还包括停机、施工与重新认证。因此「在不换主机的前提下加一块加速器」,在商业上比「换一代 SoC」要容易说服决策者得多。
2 到 5 瓦:决定 AI 功能能不能落地的硬约束
安霸把限制条件说得相当直白:一台曾经只跑单个检测模型的摄像头或检测系统,现在要同时跑好几个,而且常常要组合传统计算机视觉、视觉语言模型与自然语言接口。这些 AI 功能能不能在一台嵌入式产品里跑起来,取决于一些没有弹性的因素——功耗、散热余量、延迟与系统成本。
X7 给出的答案是 2 到 5 瓦的功耗区间。按公告的说法,这是在其当前客户设计中实测的工作区间,好处是加速器可以落在平台原有的能耗与散热约束之内,不用改变机壳尺寸,也不必显著抬高物料清单成本。这一点非常重要:对一台已经定型的产品来说,机壳、风扇与供电往往是最难动的部分,任何超过原有热设计功耗的加速器都必须伴随一次结构重做,那样「免重设计」的前提就消失了。
算力类型上,X7 支持 CNN、视觉 Transformer、多模态 Transformer 以及混合网络,用的正是安霸集成在自家 SoC 里的同一套 CVflow 计算机视觉与深度学习处理器。从卷积网络到 Transformer 再到多模态,模型结构在近几年发生了明显位移,边缘设备能不能跟上,取决于加速器对算子集合与内存带宽的支持是否覆盖新架构——这也是为什么厂商在宣传加速器时,通常会把「支持哪些模型家族」放在算力数字前面。
接入方式与软件连续性
X7 是一颗与主机无关的加速器:通过单通道 PCIe Gen 3 或者 USB 3.2 连接到主机,在系统里表现为一个标准的 PCIe 设备。主机也可以是安霸自家的 SoC,因此已经在出货安霸方案产品的客户,也有一条在不动板子的前提下提升某个负载 AI 性能的路径。
软件侧,X7 由 Cooper 开发者平台支持——这是服务安霸所有 AI SoC 的同一套环境,包括编译器、量化与性能分析工具、C++ 与 Python 运行时 API,以及多模型流水线所需的调度与内存管理。Cooper 模型花园(Cooper Model Garden)里的模型同样被设计为可以在 X7 上运行,配套的文档、示例代码与工程支持与安霸 SoC 客户一致。
更关键的是「不用重写」这一点。因为 X7 与安霸 SoC 产品线共享 CVflow 架构,为某颗 SoC 构建的模型或感知流水线,被设计成可以直接搬到 X7 上,路径与产品线迁移到下一代集成 SoC 时相同。CVflow 已经演进到第三代,安霸自 2015 年起就在硅片里做神经网络处理,按其口径,目前部署在外的 AI 处理器超过 5000 万颗。
XCalibur 参考设计与市场路径
配套的参考设计与开发平台叫 XCalibur:一张标准 2280 规格的 M.2 卡,带 LPDDR5 内存,PCIe 吞吐超过 840 MB/s,可以同时处理多路视频流与多个 AI 模型。安霸表示打算把完整的 XCalibur 设计文件提供给客户,让 OEM 或 ODM 可以在同一份设计上从评估走到量产模块——这是把「样片」变成「可交付产品」的常见做法,也决定了客户导入的时间成本。
目标市场列得相当宽:零售与实体安全、工业检测与制造、移动机器人与无人机、智能交通与关键基础设施,以及自助终端、POS、网关、本地 AI 设备这类企业边缘系统。安霸特别提到,X7 并不局限于摄像头,它可以处理多种数字与物理数据模态,因此适合边缘基础设施推理系统,也适合机器人这类端点设备。销售渠道除了直销,还包括 9 月 3 日宣布的 Capgemini 与 Macnica 合作渠道:前者面向大型企业的复杂部署,后者覆盖美洲与 EMEA 的中小客户、独立软件供应商、OEM、ODM 与系统集成商。
可获得性方面,X7 目前处于样片阶段,XCalibur 评估套件面向合格客户提供。安霸在 9 月 15 日至 17 日于圣克拉拉会议中心举行的 AI Infrastructure Summit 上进一步介绍了 X7。
公司总裁兼首席执行官 Fermi Wang 的说法是:很多客户的现场系统,是在终端用户如今期待的 AI 负载还不可能实现的年代设计的;X7 把运行在超过 5000 万颗安霸 AI SoC 里的第三代 CVflow 引擎,带到了客户已经大规模部署的平台上。他同时给出了边界——当团队围绕 AI 设计整个系统时,集成式 SoC 仍是最强选择;X7 覆盖的是其余场景:平台已经在现场,或者仍在做原型。
保持怀疑同样有必要。所有功耗、吞吐与算力相关的数字都来自安霸自己的客户设计,没有第三方基准;「5000 万颗」是累计出货量而非当前活跃量;样片阶段的器件到量产还有工程验证与良率爬坡的距离。真正值得观察的是两件事:这块卡最终能卖出多少片进入存量设备,以及当主机是别人的 x86 平台时,软件栈的移植是否真的像公告里那样平滑。