Figure「Helix 2.5」:人形机器人零样本泛化到 30 个陌生家庭
一件人类习以为常、机器人做不到的事
9 月 17 日,Figure 发布新一代人形机器人控制模型 Helix 2.5,公司称这是「我们构建过的最先进的神经网络」。它要回答的问题听上去很朴素:一个人走进陌生的家,可以立刻开始干活——不需要因为床的高度不同而重新学一遍铺床,也不会因为家具换了样式就不知道怎么收拾房间。而机器人此前不是这样,它们是「在哪里干活,就在哪里学」,一个地方一个地方地学。
上一代 Helix 02 已经展示过神经策略能协调人形的整个身体完成长程任务:卸载洗碗机、连续 200 小时自主执行物流作业。但这些系统的训练数据,恰恰采自它们将来要工作的那些场所。Helix 2.5 想越过这条线:用一个在人类行为数据集 Index 上预训练出来的基础模型,去支撑从未到过的家。
从 9% 到 56%:一次只改一个变量
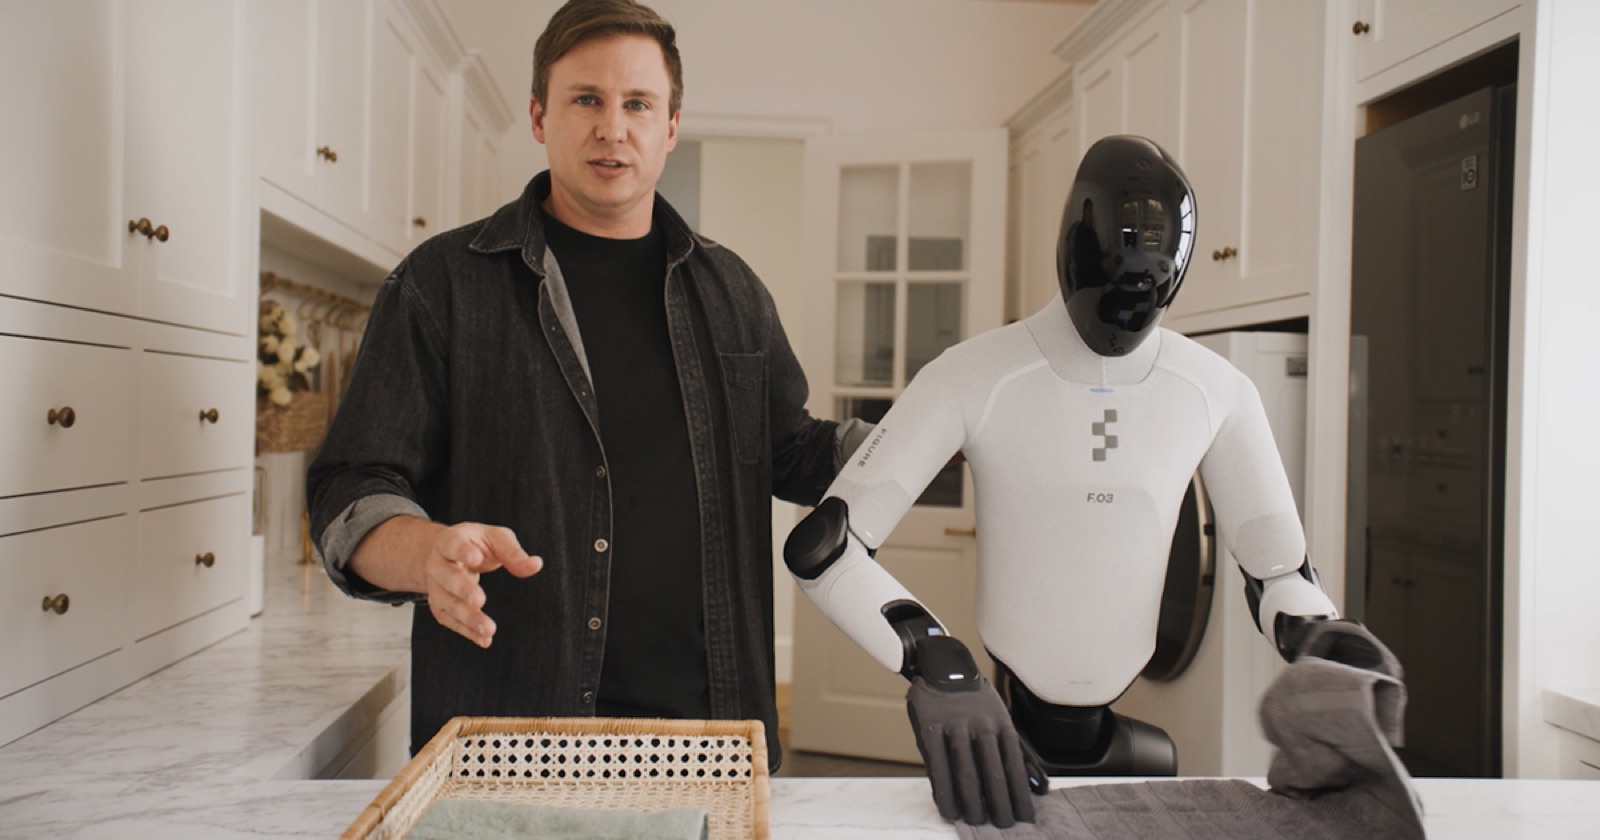
Figure 从同一个 Index 预训练底座上派生出三种行为:收拾客厅、叠毛巾、铺床,然后带着机器人走进 30 个湾区住宅。三类任务合在一起,同时考验感知、行走、操作、双手协同与全身控制:收拾房间要求把散落的 13 到 15 件玩具全部拿起放进篮子,叠毛巾要求把毛巾折好放进篮子,铺床则要求两个枕头与被子两个角都到位、被子拉平。
「零样本」在这里有严格定义:评估所用的每一个家庭、每一件被操作的物体,都从未出现在任务说明数据里;机器人使用的是每户人家现成的沙发、床和折叠台面。评估物体在实验开始前就被单独封存,先由 AI 模型、再由人工复核确认它们没有进入任务说明数据。全部 30 个家庭共用同一个固定检查点,权重不针对任何家庭或物体做调整,检查点的挑选也不参考任何评估回合的表现。
最关键的对照实验只有一个变量。Figure 用完全相同的任务说明数据训练两个策略——这份数据里同样不含评估家庭与评估物体:一个从随机权重开始训练,另一个从 Index 预训练的 Helix 2.5 初始化。架构、优化器、超参数、下游数据与评估方式全部固定,唯一差别就是有没有 Index 预训练。
盲测结果:从零开始训练的策略零样本成功率 9%,Index 预训练的策略 56%,提升超过六倍。Figure 的结论是,Helix 2.5 的零样本能力大部分来自 Index 预训练,而不是任务说明数据本身。还有一个能说明预训练宽度的数字:在体量庞大的 Index 预训练集里,任何一个评估任务所占的比例都不超过 1.90%。起点也不同——Helix 02 是从一个预训练的视觉语言模型出发,Helix 2.5 则是完全从随机初始化、在 Index 上预训练出来的。
成功口径同样严格:任务必须整段完成才算成功——每一件玩具都进筐、每一条毛巾都折好、整张床都铺完,Figure 不给部分得分。评分细则在评估开始前就已固定:每件玩具限时 1 分钟,超时即中止该回合;每条毛巾限时 3 分钟,并按四个角能否在 1 英寸内对齐分 A、B、C 三档;枕头必须被拿起并放到床的上三分之一,朝向偏差小于 15 度算好、小于 45 度算差;被子两侧都要被抓起、两个角都要到达床的上三分之一,两角相差 6 英寸以内算好、6 到 12 英寸算差。任何一回合只要需要人工介入以保证安全,该回合就中止并记为失败。
成本减半、自我纠错与一条缩放曲线
预训练是否改变了「指定一个新行为需要多少机器人数据」?Figure 把 Helix 2.5 与一个执行同一任务的旧 Helix 02 策略做了对比。旧策略的训练数据直接采自它被评估的那个环境,而 Helix 2.5 只用了它一半的适配数据就达到相当的成功率——还是跨 30 个陌生家庭零样本完成的。用 Figure 的话说:行为规格的成本减半,泛化范围扩大 30 倍。
预训练还带出一个定性变化:全身自我纠错。长程任务、尤其在不熟悉的环境里,机器人难免做错一步;Helix 2.5 会退回去重新对位、改变站姿,甚至绕到床的另一侧把没折好的角重新处理。Figure 把这种「从错误中恢复并继续推进」的能力,视为 Index 预训练的结果,而不是专门训练出来的技巧。
缩放律曾经改变语言模型的开发方式:下一词预测的误差会随数据与算力增加而可预测地下降,于是小规模实验可以用来预测大规模训练的结果。Figure 想知道,人类经验到机器人的迁移是否也遵守类似规律。他们用 Index 的嵌套子集训练了四个模型,预训练数据量跨度 8 倍,模型规模与下游训练方式保持不变,每个模型都用同一份任务数据微调、在同一份留出的动作预测损失上评估。结果是每把 Index 数据翻一倍,损失就按预期下降;更精确的是可预测性——只用规模较小的几次运行,就能在训练开始前把最大一次运行的测试损失预测到小数点后四位,预测误差只相当于整个 8 倍数据区间变化的 0.54%。Figure 称这是首个在人形机器人上测出的人到机器人迁移缩放律,它衡量的是数据这一维的缩放。
为什么「家」是更难的考场
机器人泛化研究大多发生在为机器让步的环境里:在桌面上工作的机械臂有固定工作空间,轮式机器人需要足够开阔的地面容纳底盘转身。住宅不会这样配合。人形必须作为任务的一部分在住宅里移动,在局促、杂乱的动线里摆正身体,才看得见、够得到、操作得了。于是任务变成全身问题:感知、行走与操作无法分开求解。零样本又把难度推高一层——房间、布局、物体在训练里都没见过,到现场也没有适应期,机器人只能凭已经学到的东西把完整的感知与控制问题解出来,而在这种复杂度上的人形自主行为即便在熟悉环境中也属罕见。
Index 的构建方式值得一提。Figure 用两种嵌入来刻画其中的任务:对每个片段做视频嵌入,再用视觉语言模型对每段的活动与物体描述做文本嵌入,把两者分别聚类成嵌套的语义层级,然后衡量任意一份数据或训练快照在这些语义组上的小时数分布。正是这种广谱的预训练,才支撑得起任意行为的微调,也是 Figure 说「首次在这一规模上做到零样本全身泛化」的依据。
该保留的怀疑也不能省。这是公司自测的结果,不是独立复现的基准,Figure 自己也强调通用人形机器人远未被解决;所谓零样本,限定的是评估环境与被操作的物体,三个任务本身仍由在别处采集的微调数据来指定。56% 意味着接近一半的整段任务没有完成——对家庭场景来说,这个数字指明了方向,但还谈不上可用性。
Figure 给出的下一步仍是大模型那套熟悉的配方:在预训练里广泛地学,把行为一次性指定好,到部署时再泛化。他们披露 Index 正以每秒约 35 分钟人类经验的速度增长,并已承诺 35 亿美元算力用于训练 Helix。一年前,Figure 的判断是机器人行业在模型规模、算力和数据上差了好几个数量级,Index 与 Helix 2.5 是他们给出的答卷。