Physical Intelligence 开放 Pi API beta:机器人基础模型走向云服务
从「发论文」到「模型即服务」
10 月 13 日,Physical Intelligence(π)宣布最新机器人模型通过 Pi API beta 对外开放:开发者上传自己的机器人数据、在 π 管理的算力上启动微调,再通过托管的推理网关把微调后的模型跑在自己的机器人上;官网同步开放等待名单。这条新闻本身不长,但它标志着一次定位转变——从「发论文、放演示」转向「模型即服务」。
π 在发布稿里给出一个设问:如果最新、最强的机器人基础模型,可以通过一个简单、开箱即用的 API 被适配到每一个具体应用上,会是什么样?他们的回答是:π 会把这件事做掉——你上传数据,微调跑在他们的算力与基础设施上,推理则由托管的网关提供。由于 π 可以快速更新支撑 API 的模型,他们计划让开发者持续用到最新、最强的模型。
为什么需要这一层 API?部署机器人本身就是件难事:除了找对用例、把硬件做对,开发者还需要足够聪明的模型来完成手上的任务。π0、π0.5 这类通用机器人基础模型给出了一个不错的起点——它们提供物理知识与能力的底座,能显著减少适配新任务、新环境或新机器人所需的数据与工作量。但适配它们仍然需要机器学习基础设施、算力与复杂的数据管道,而这些本身就不容易搞定。API 把这一段打包成了产品。目标依旧是那句老话:一个模型控制任意机器人。API beta 是他们所称「为社区提供物理智能底座、实现端到端自主」的第一步;发布稿同时强调他们还很早期,开发者的反馈会塑造后续版本。
一个循环:采数据、训模型、上机测试、用失败决定下一批数据
为了确认 API 能支撑多样化的应用,π 想回答两个问题:模型能不能覆盖不同行业的多种应用与机器人硬件?API 能不能让开发者轻松地朝「有用的、实用的自主性」迭代?他们的做法是和正在部署机器人的公司紧密合作,在真实应用中验证模型在不同任务、硬件与运行环境下的表现。
在这些早期合作里,π 发现了一个共同点:具体的麻烦各不相同——一件里外穿反的衣服、一种待不住在铲斗里的原料、一个落错了位置的制造零件——但改进的流程几乎一样:采集演示数据、训练模型、在机器人上测试、再根据失败的情况决定下一批该采什么数据。Pi API 就是把这套循环交到开发者自己手里,用的还是 π 最新的模型。
这是机器人基础模型落地时绕不开的循环。策略的表现取决于数据覆盖了多少种失败情形,而演示数据往往要靠上一轮测试暴露的问题来定向补齐;因此评测数据既是验收标准,也是下一轮采集的指南。π 在 API 的流程说明里把它画成四步:上传数据、微调 π 模型、通过托管推理在机器人上运行、用评测数据指导下一次迭代。
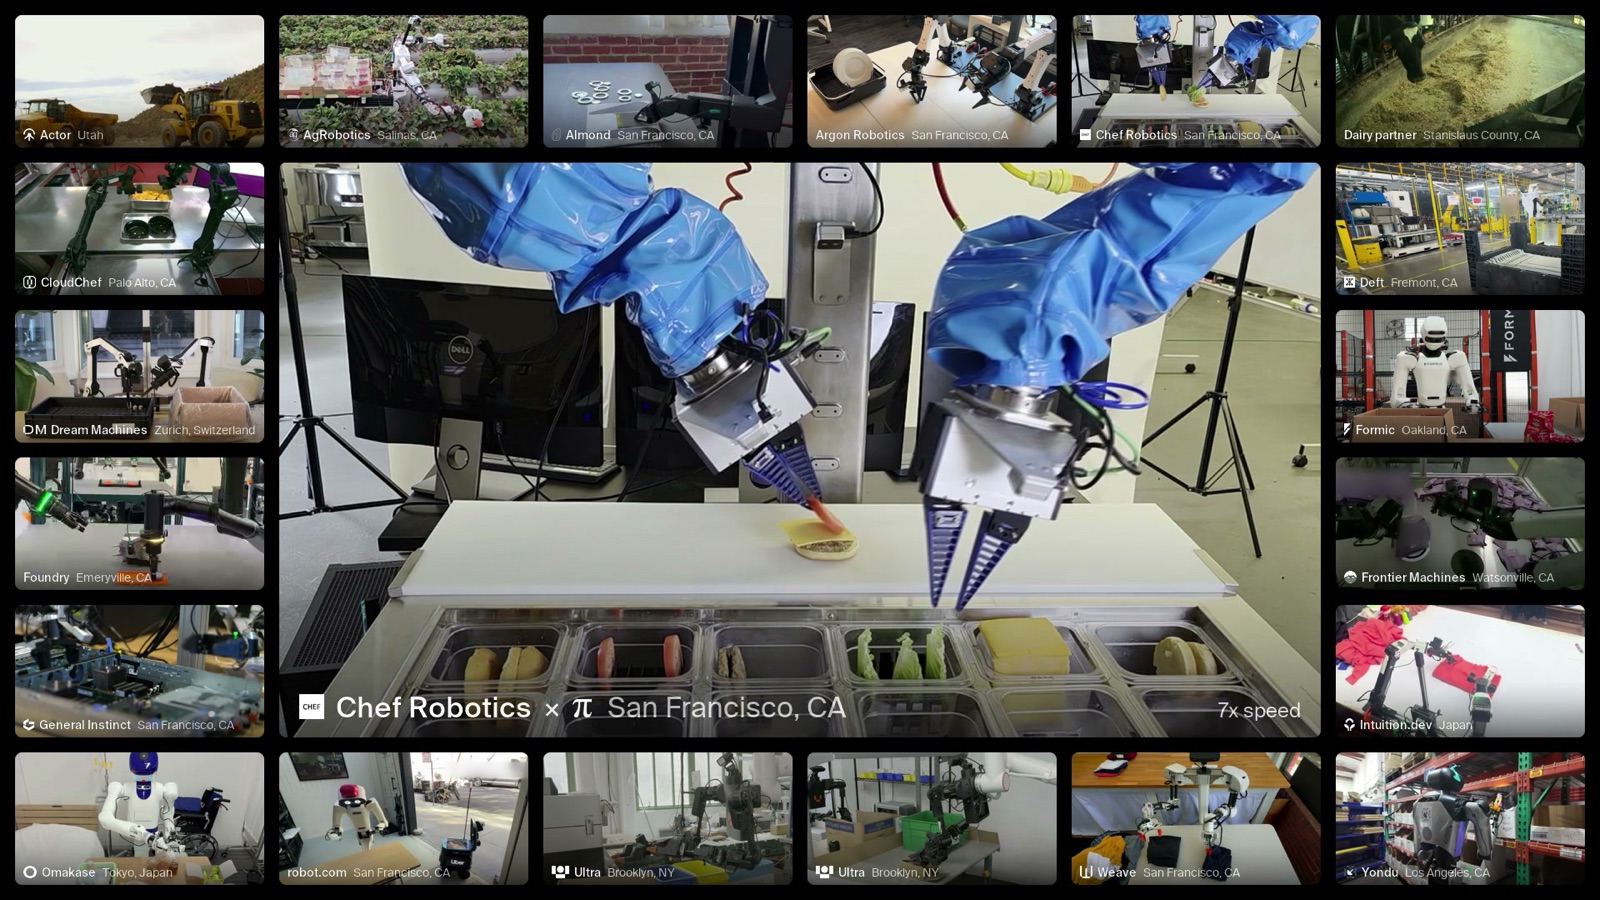
他们已经把 API 提供给一小批公司做早期访问,用来测试这些公司能否自行提升自主性,结果反馈是启动速度与进展都超出预期。值得一提的是运行方式:原始页面里展示的多数应用——从日本到瑞士,再到美国各地的部署——都是通过 API 的云端推理运行的;而这些早期部署暴露出的问题之一,是部分场景的网络连通性挑战。
早期用户都在做什么
Actor 是其中之一,它部署自主重型机械:自主轮式装载机在一次真实的商业部署中铲起物料并装进自卸车,全过程机器里没有操作员。这类场景对「云端推理」的容忍度,取决于现场网络与安全冗余怎么设计。
另一个例子是 Almond:它做的是 Axol 双臂机器人,目标是让 Axol 最终能造自己。页面上的演示是 Axol 为自己装配中使用的垫片去毛刺,用的模型是团队迭代 Pi API 四天后得到的。四天这个时间尺度,正是 API 想要证明的事——适配不必以月计。
名单里还能看到 AgRobotics、CloudChef、一家乳业合作方、Ultra、Weave 等已在合作中展示的应用方;早期访问的名单则更长,包括 Argon Robotics、Chef Robotics、Deft、Dream Machines、Formic Robotics、Foundry、Frontier Machines、General Instinct、Intuition.dev、Omakase、robot.com、Yondu 等,此外还有一次黑客松。π 的描述是:这些早期部署横跨多种环境与任务。
技术底座与该留的余地
API 背后是一系列已公开的工作。2026 年 4 月 16 日发布的 π₀.₇ 是一个「可转向」的通用机器人基础模型,强调涌现的组合泛化:能操作没见过的厨房电器,能把技能迁移到不同的机器人与环境上,还能在一台从未学过叠衣服的新机器人上直接叠衣服。它的训练数据混合了多机器人数据、人类视频与自主机器人回合。更早的公开工作包括主打开放世界泛化的 π₀.₅、从经验中学习的 π*0.6,以及面向十分钟以上长任务的 MEM 记忆。
这里也能看出商业化路径:π0 与 π0.5 的模型与代码是公开的,而 API 卖的是最新模型加上托管好的微调与推理基础设施。开源打底、最新能力按服务收费,这正是「模型即服务」的典型结构,也解释了为什么 π 强调自己可以快速更新 API 底下的模型。
需要留有余地的地方同样清楚。这些结果多为公司自报,评测基准也与学术界的常规设定不同;通用机器人的家务能力距离可靠仍有明显距离,而页面上展示的应用大多集中在工业、物流与制造等结构化场景。另一个现实约束是云端推理:托管网关让开发者不必自建基础设施,但也就把网络变成了运行链路的一部分——π 自己提到部分早期部署遇到网络连通性挑战,对工厂产线与户外机械来说,端侧推理在相当长时间内仍是必需的选项。
π 自己对这件事的理由说得很实在:真实世界的机器人应用太多了,机器人施工、机器人手术、仓储自动化,每一个都值得一整家公司去做;如果每个应用都要从零解决物理智能问题,这些挑战会变得无法逾越。把模型通过 API 放出去,既加速了整个机器人生态的成长,也顺带加速了他们自己对物理智能的理解——这大概是「模型即服务」在机器人领域最直接的一层意义。