树莓派 AI HAT+ 2 开卖:40 TOPS,本地跑生成式模型
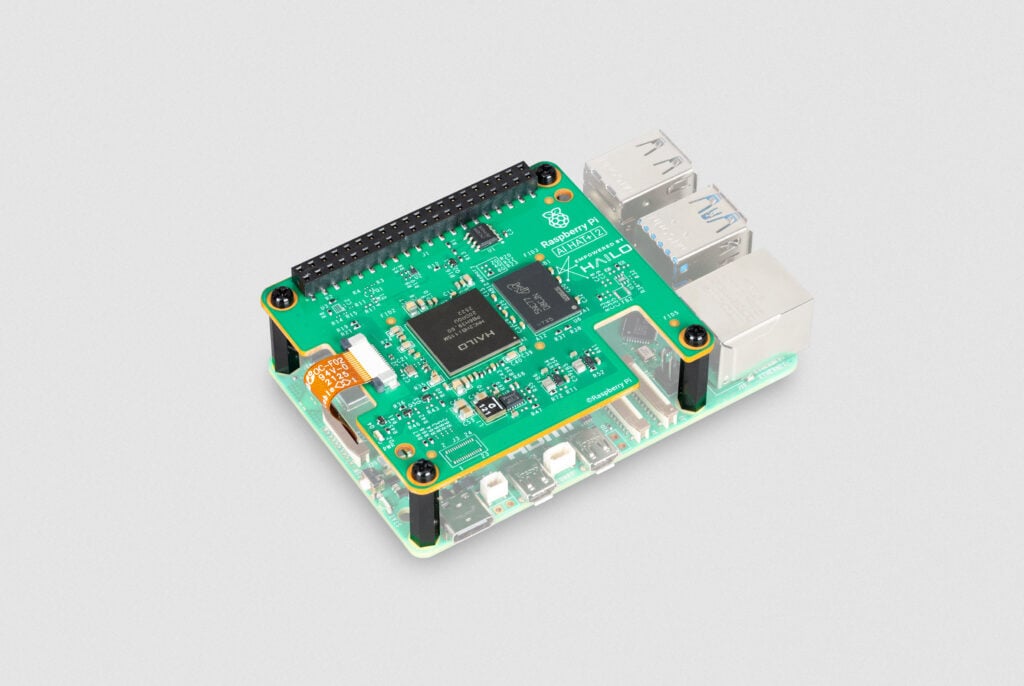
1 月 15 日,树莓派发布 AI HAT+ 2,面向 Raspberry Pi 5。它搭载 Hailo-10H 加速器,算力最高 40 TOPS,板载 8 GB LPDDR4X 专用内存,售价 130 美元,发布即开卖。与常见的「先发布、后到货」不同,这块板子当天就可以下单。
与前代最大的差别在于能跑什么:除了计算机视觉,AI HAT+ 2 可以在本地运行语言模型与多模态(VLM)工作负载,官方把它称为第一款为填补生成式 AI 空白而设计的 AI 产品。换句话说,它的目标不是让树莓派看得更清楚,而是让树莓派能对话、能写代码、能看着画面说出一段描述。
从产品线看,这也是树莓派 AI 策略的一次转向。一年前推出的初代 AI HAT+ 走的是「把视觉推理做快」的路线,面向摄像头与机器视觉;而 AI HAT+ 2 把目标改成了「把模型跑起来」——同一个硬件形态,服务的是完全不同的应用假设。
40 TOPS 与 8 GB:两个数字的分量
先说 40 TOPS。TOPS 指每秒万亿次运算,是加速器算力最常用的口径;但同一个数字在不同精度下的含金量并不相同——AI HAT+ 2 的 40 TOPS 是 INT4 精度下的数值。整数量化位宽越低,单位面积能塞进的算力越多,代价是精度损失,因此边缘芯片的算力指标必须连着精度一起看,只比 TOPS 很容易得出错误结论。
第二个数字可能更关键:8 GB 专用内存。更早的 AI HAT+ 提供 13 或 26 TOPS,主要面向视觉任务,没有这样一块独立内存;而跑语言模型时,权重与 KV 缓存都要占内存,板载内存的大小往往比峰值算力更早成为瓶颈。模型能不能装下、上下文能开多长,本质上由这块内存决定,这也解释了为什么它能第一次谈「生成式」。换句话说,算力决定了能不能跑,内存决定了能跑多大——后者往往才是决定体验的那一个。
开箱能跑什么
发布时可安装的语言模型包括 DeepSeek-R1-Distill(15 亿参数)、Llama3.2(10 亿)、Qwen2.5-Coder(15 亿)、Qwen2.5-Instruct(15 亿)与 Qwen2(15 亿)。更多、更大的模型正在准备中,预计在发布后不久提供。从清单可以看出一个规律:参数规模集中在 10 亿到 15 亿之间,正好与板载内存的容量相称。
使用方式上,官方示例采用 hailo-ollama 作为推理后端,搭配 Open WebUI 前端,在浏览器里提供熟悉的对话界面,全部推理都在本地完成。示例覆盖了常识问答、代码任务、中英翻译,以及用 VLM 描述摄像头画面——最后一项把相机与语言模型串了起来,也最能体现这块板子与纯视觉加速器的区别。从工程角度看,这些示例的价值不在演示效果,而在于把「部署链路」跑通:模型怎么装、后端怎么起、前端怎么接,都能照着复现。
不过要摆正预期。云端主流大模型动辄 5000 亿到 2 万亿参数,而板载内存能装下的边缘模型通常在 10 亿到 70 亿参数之间。这类小模型的目标不是复刻大模型的知识面,而是在受限数据集内可靠工作——换言之,领域内听话,比什么都懂更现实。这也是所有边缘 AI 方案共同的前提:先接受模型规模的上限,再在这个上限里寻找最有价值的任务。
能改、能调:LoRA 与相机链路
弥补差距的办法是微调。视觉模型可以用贴合场景的图像数据集重新训练;语言模型这边,AI HAT+ 2 支持基于 LoRA(低秩适配)的微调——只训练一小部分适配参数、主体权重保持冻结,再把适配器编译进模型。官方提供的 Hailo Dataflow Compiler 用来做这类编译工作,也就是说,「先通用、再专用」这条路是通的。对工业与教育场景来说,这一点可能比模型清单更重要:能改,才谈得上适配自己的数据。
对已经在用初代 AI HAT+ 的开发者,过渡基本平滑:视觉模型(如 Yolo 目标识别、姿态估计、场景分割)的表现与前代 26 TOPS 版本大致相当,靠的正是板载内存;与相机软件栈(libcamera、rpicam-apps、Picamera2)的整合也保持一致。此外,该板通过 PCIe 连接,因此面向 Raspberry Pi 5。这也意味着它无法插到更早的树莓派上——接口决定了兼容范围,而不是软件。
它与 MCU 级 NPU 不在同一档
定位上需要说清:Pi 加 AI HAT 属于「Linux 单板机 + 外挂 NPU」。它与 MCU 级 NPU(例如 STM32N6、MCX N947 这类带加速器的微控制器)不在同一档——功耗、启动复杂度与时延都更高,但能跑的模型大得多。选型的分界线其实很清楚:如果任务要求毫秒级启动、微安级待机,就该去 MCU 那边;如果要跑语言模型、要接屏幕与网络,单板机加加速器才现实。
HAT 这个形态本身也值得一提:它以叠加板的方式接在主板之上,借助既有的连接与供电,把新增功能做成可以随时加装的模块。对爱好者与教育场景,这比重新设计一整块板子友好得多,也让升级路径变得简单——主板不动,算力可以换。对照同期的其他方案,它的价值更多在于「可获得的算力」,而不是「最高的算力」。
价格与门槛也值得说一句。130 美元对个人开发者不算小数目,但相对于此前为了跑同类模型所需的显卡与整机,它把门槛压到了「再加一块扩展板」的量级。这件事本身,比任何单项参数都更能解释它受关注的原因。
这件事的意义在于可及性:入门级的边缘生成式 AI 现在能在一块爱好者熟悉的单板机上完成,本地 LLM 一体板开始进入爱好者生态。它不会替代云端模型,但它把「不联网、不上传、不订阅」这条路线变得可负担——数据不出设备,也就谈不上上传。当然,它也有明确的边界:模型规模受限、并发能力有限,还需要一块 Raspberry Pi 5 作为底座,这些都不适合用「小而全」的期待去看它。