華為釋出 Atlas 960E 超節點:業界首個 NPO 光互聯,4096 卡 8 EFLOPS
超節點:把整個叢集當成一臺機器來設計
9 月 17 日,華為全聯接大會 2026 在上海開幕。輪值董事長 David Wang 在主題演講裡釋出了 Atlas 960E 超節點,官方定位是「業界首個基於 NPO(近封裝光學)的超節點」,目標是支撐十萬億引數級模型的訓練與推理。華為同時重申了自己的 AI 戰略:以算力為中心、靠系統與架構創新立足,並通過開源開放建立生態。
理解這場釋出,要先理解「超節點」在華為語境裡的含義:它不是一臺伺服器,也不是一顆晶片,而是把大量 NPU 通過統一協議以點對點方式互聯,支援跨物理伺服器的記憶體訪問,近距用銅、遠距用光,最終讓整個叢集在軟體看來更像一臺計算機。這條路線的終點是「超叢集」——用超節點堆出十萬卡級算力。
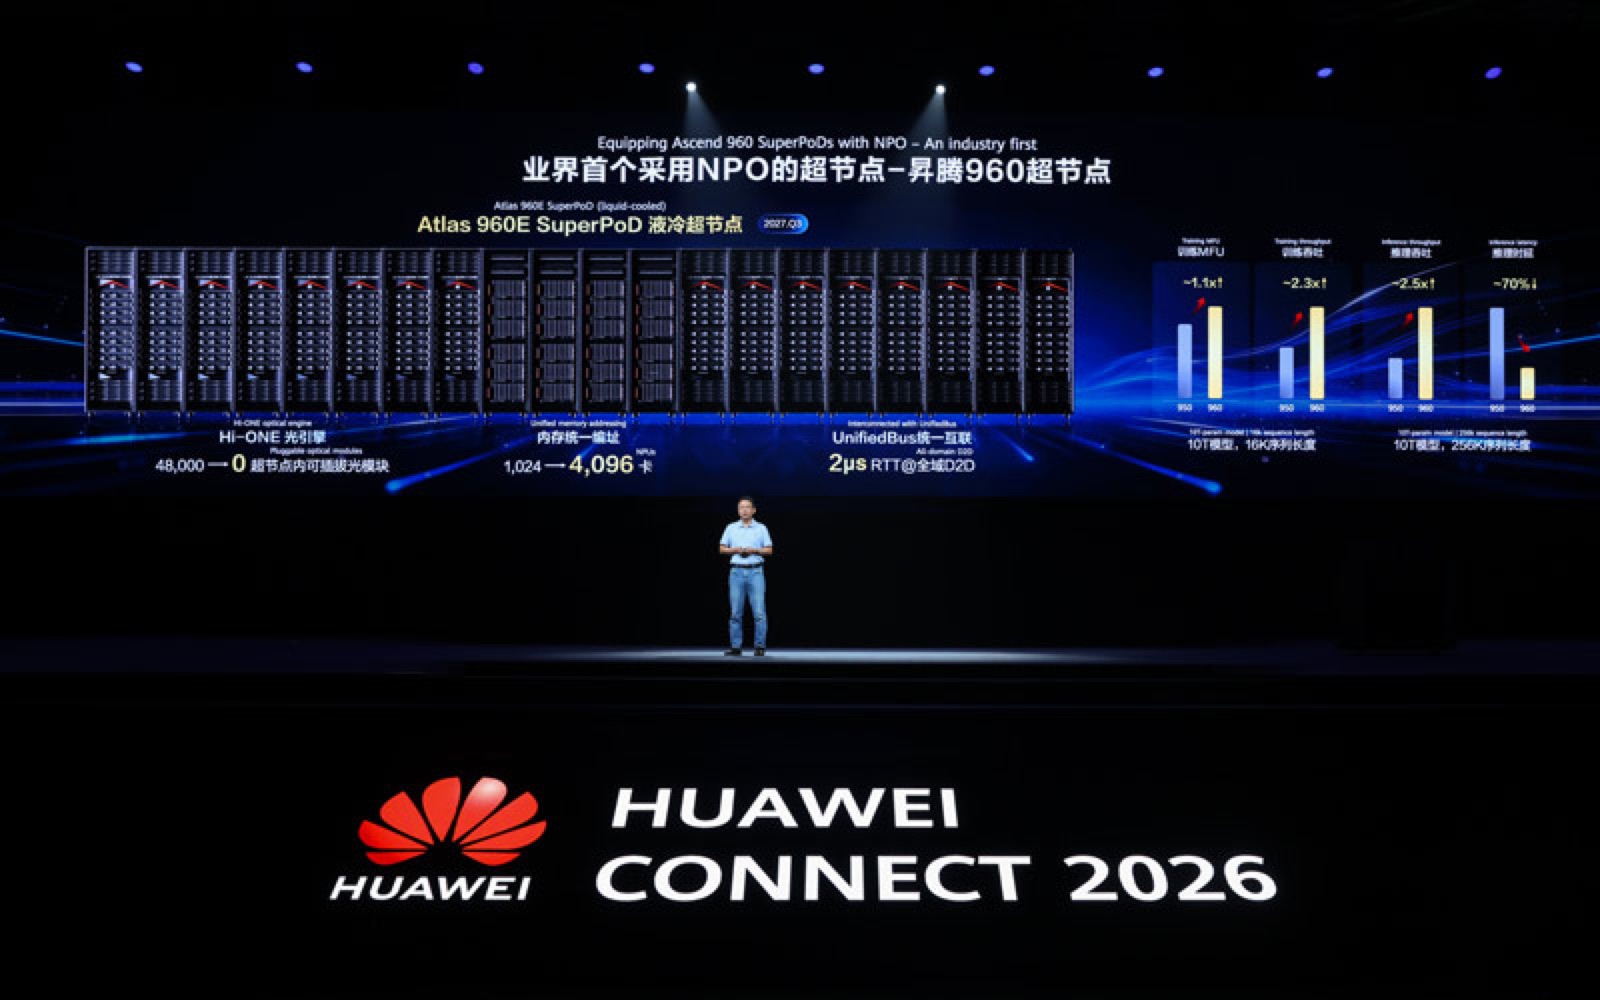
Atlas 960E 的具體引數是:單節點最多 4096 顆 NPU,FP8 精度下 8 EFLOPS,FP4 精度下 16 EFLOPS;採用正交架構與全液冷設計;藉助 UnifiedBus 實現記憶體統一編址。華為表示,這樣的規模是面向十萬億引數模型準備的。
互聯層面,華為用了自研的統一匯流排 UnifiedBus,由它承載記憶體統一編址,讓單個超節點擴充套件到 4096 顆 NPU。這也是「超節點」與「一堆用網線連起來的伺服器」的根本區別:前者讓跨伺服器的記憶體訪問發生在同一個協議之內,軟體不必為規模變化改寫模型。相關效能指標都來自華為的釋出材料,尚無第三方獨立驗證。
Hi-ONE:5500 個光引擎替掉 48000 個光模組
光是這套系統裡最顯眼的變數。傳統做法是給每一顆 NPU 配一整套 800G 光模組,規模一上來,模組數量、功耗與故障點都會同步膨脹。華為給出的替代方案是把光引擎挪到更靠近交換晶片的位置,縮短電訊號走線,用少量引擎替代大量模組。
要理解 NPO 為什麼值得單獨講,得看光互聯在超大規模集群裡的位置。當節點數從幾百漲到幾千,電互聯的距離與功耗會迅速變得不可承受,業界因此不斷把光電轉換點向交換晶片靠近:從可插拔光模組,到近封裝光學,再到把光引擎與晶片共封裝,這條路線上的每一步都在換取更高的頻寬密度與更低的每位元功耗。華為這次把重心放在「近封裝」這一檔,並強調相關產品已經進入量產。
這臺超節點裡塞進了 5500 個 Hi-ONE 光引擎。華為稱,如果按傳統方案連線同樣數量的 NPU,需要 48000 個 800G 光模組;換成 Hi-ONE 之後,功耗降低超過 550 千瓦,系統無故障執行時間翻倍,可用度達到 99.8%。Hi-ONE 全稱 High-density Optical-interconnect-Node Engine,單引擎傳輸容量 7.2 Tbit/s,華為稱其是業界首個量產、容量最大的 NPO 產品,也是目前唯一內建光源的 NPO。
「內建光源」這幾個字值得多看一眼。光互聯的可靠性瓶頸常常不在引擎本身,而在外部雷射源的耦合與壽命管理;把光源做進引擎,理論上能簡化系統結構、減少外部光纖與聯結器,但同時對封裝與散熱提出更高要求。華為在釋出材料裡強調,Hi-ONE 做了光學、機械、電氣、電磁與熱的多物理場協同設計。
不止 AI:泰山 950 與上下文儲存
華為把這套架構從 AI 推到了通用計算。升級後的泰山 950 超節點同樣基於 UnifiedBus 全光互聯,最多支援 4096 個節點,統一記憶體池容量可達 256 TB。官方給出三個受益場景:更高密度的智慧體沙箱、更快的沙箱啟動速度,以及更好的智慧體向量檢索效能。
儲存側,華為釋出了 OceanStor M900,一款基於 UnifiedBus 的上下文儲存叢集,支援一跳直達訪問,為 L3.5 層提供 PB 級 KV cache 容量。所謂 L3.5,指向的是大模型推理中那個既不屬於視訊記憶體、也不屬於傳統主存的中間層——KV cache 隨著對話變長呈指數增長,把它放在哪裡,直接決定長上下文服務的成本。
從 51.2 萬卡到百萬卡,以及開源的 CANN
超節點之外是超叢集。華為給出的擴充套件路徑是:用 UnifiedBus 網路或 RoCE 把多臺 Atlas 960E 超節點連線起來構成超級叢集;採用兩級四平面 Clos 架構時,最多可互聯 51.2 萬顆 NPU;再疊加多軌拓撲,則可支援到 100 萬顆 NPU。
華為同時把「開源開放」列為戰略的一部分。釋出中明確提到 CANN 已完成開源開放,進入社群驅動的持續開發階段,官方說法是從「可用」走向「好用」,並稱這是昇騰生態的新拐點。對使用者來說,這意味著軟體棧的迭代節奏不再完全掌握在單一廠商手裡,而這一點恰恰是國產算力能否被外部團隊真正接納的關鍵變數之一。
該保留的懷疑同樣要說清楚。這份釋出裡幾乎全部關鍵數字——8 EFLOPS、4096 卡、99.8% 可用度、百萬卡叢集——都出自華為自己的材料,屬於產品規劃與設計目標,不等於已經在客戶現場跑滿的實測成績。超節點路線本身也還在演進中,光引擎的良率、統一編址的軟體適配、叢集級運維,都是需要時間才能驗證的部分。
不過有一點值得放在更大的背景裡看:這一代競爭的重心,正在從「單顆晶片的峰值算力」轉向「系統、互聯與軟體生態」。光互聯、統一編址、液冷、叢集規模,這些詞過去屬於基礎設施工程;如今它們直接決定一個大模型能不能被訓練出來、一次推理要花多少錢。華為選擇的路是先做好光和系統,再用開源生態拉開發者——這條路能不能走通,最終不看釋出會上的 EFLOPS,而看客戶機房裡那 99.8% 的可用度是否真的持續成立。