SK 海力士在 OCP 峰會給出「記憶體中心」答案:CXL 記憶體池、MARS 機架與 CMM-Ax
記憶體牆與一個判斷
10 月 12 日至 15 日,OCP Global Summit 2026 在加州聖何塞舉行。OCP 是面向資料中心硬體設計與規範共享、標準化的技術會議,今年的核心議題之一,正是支撐 AI 繼續前進的基礎設施技術。SK 海力士把展臺的一大塊留給了「系統級演示」——不是把晶片擺在玻璃櫃裡,而是把下一代記憶體方案裝進真實系統裡跑起來。
這家公司給出的判斷只有一句話:以記憶體為中心的伺服器系統是未來。背景是 AI 處理的資料量爆炸式增長,資料瓶頸成為新的難題:以 CPU 和 GPU 為中心的既有架構撞上了「記憶體牆」,功耗也在同步飆升。SK 海力士的答案是讓記憶體在系統裡佔據核心位置,而不是繼續當配角。
把記憶體做成池子:CMM-DDR5 與 CXL
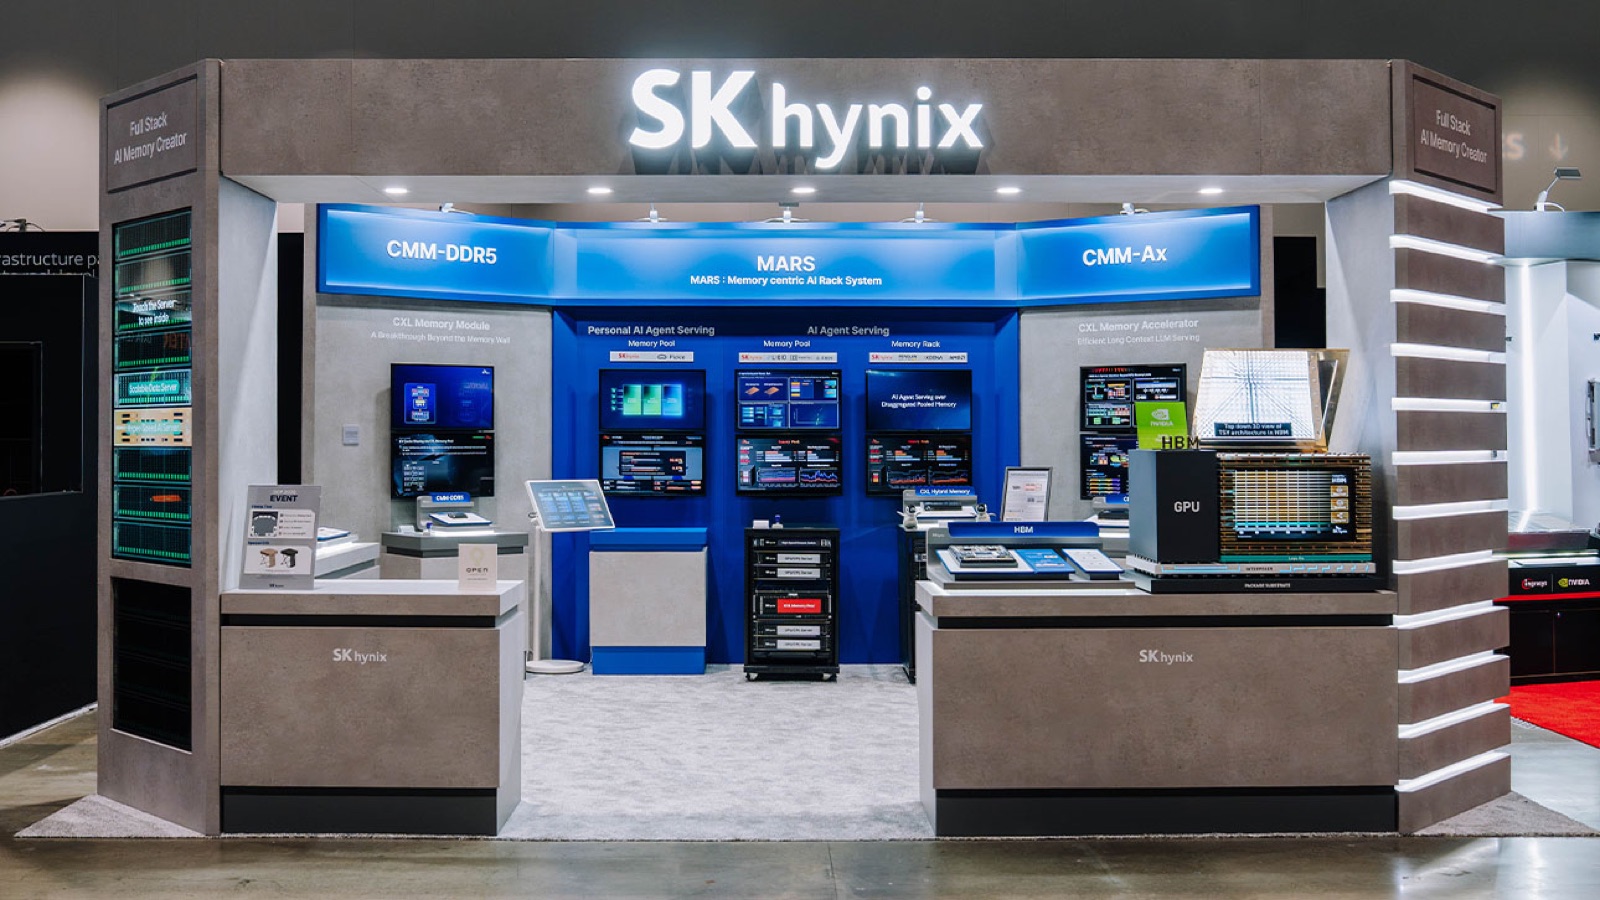
演示區從左到右排開三套方案:CMM-DDR5、MARS 與 CMM-Ax。CMM 即 CXL Memory Module(CXL 記憶體模組),思路是讓多臺伺服器共享一個記憶體池、按需取用,從而提高資源利用率。CXL 本身是基於 PCIe 的互聯標準,用來把 CPU、GPU 與記憶體高效連在一起,並提供記憶體池化能力。
這次展出的是第二代 CMM-DDR5,容量 256 GB,基於 CXL 3.2,面向 AI 負載最佳化。相比上一代,頻寬提升一倍以上(80 GB/s),能效改善約 30%,並應用了 CXL Pooled 功能。對資料密集、負載很高的工作負載來說,這類產品被寄望於緩解記憶體瓶頸。
這項技術不是第一次露面。SK 海力士在去年 9 月與 NAVER Cloud 簽署業務協議,此後一直圍繞 CXL 記憶體方案解決雲上 AI 服務的瓶頸。本次演示中,公司給出了概念驗證(PoC)級別的結果:在智慧體 AI 環境裡共享 KV cache,以及在全模態服務 OmniServe 中共享 embedding,是否真的可行。所謂 KV cache,是大模型智慧體生成文本時快取已算結果的那塊臨時記憶體,對話越長、任務越多,它增長得越快,因此如何存與取,直接影響智慧體的表現。
MARS:以記憶體為核心的一櫃伺服器
MARS 全稱 Memory Centric AI Rack System,直譯是「以記憶體為核心的 AI 機架系統」。它的做法是把多家合作伙伴的方案整合進同一個機架,讓記憶體處在核心位置。這次 SK 海力士與夥伴一起做了三個演示。
第一個是與 Arcee、Liqid、Marvell 合作的智慧體 AI 服務演示:用池化記憶體把多臺伺服器和多顆 GPU 連起來,證明基於 CXL 池化記憶體傳輸或複用 KV cache,比傳統依賴網路通訊的方式顯著提升系統性能。
第二個是與 AMD、Penguin、Xcena、Arcee 合作的演示:驗證一套同時使用 CXL 記憶體與 CXL 混合記憶體(DRAM 加 SSD)的記憶體機架,能否高效存放並快速複用持續產生的大規模 KV cache。演示中展示了兩項能力:根據此前的對話與任務歷史預測接下來會用到哪些 KV cache,以及把這些 KV cache 提前載入進 DRAM 以加快處理。把完整 KV cache 存到 SSD 上,則同時兼顧了讀取速度與容量。
第三個演示與個人 AI 智慧體服務商 Pickle 合作,用池化記憶體降低服務響應延遲。個人智慧體要串聯多個 AI 模型,SK 海力士證明基於池化記憶體的流式傳輸可以加速這些模型之間的資料搬運,讓最終結果更快到達使用者。
負責記憶體系統研究的副總裁 Hosik Kim 在演講中把話講得很直白:這套系統「通過下一代 CXL 技術連線 CPU 與 GPU,實現機架級記憶體池化與動態零複製資料共享」,結構上顯著提升高負載工作負載的資料搬運速度。他給出的三個受益場景是:協作型智慧體的 KV cache 複用效率、個人智慧體服務中多模態全模態模型的響應速度,以及大規模圖神經網路訓練裡的不規則記憶體訪問問題。
CMM-Ax:把計算搬進記憶體,以及 HBM 與 HBF 兩條產品線
第三套方案 CMM-Ax 走的是另一條路:把計算能力與記憶體結合起來,在記憶體內部直接完成計算,不必把資料搬來搬去,從而降低資料中心的功耗與成本負擔。展臺上,SK 海力士用一套名為「高效長上下文大模型服務」的下一代 AI 推理系統演示了它,證明 CMM-Ax 能有效加速傳統 GPU 系統難以處理的長上下文負載。支撐這項成果的研究也因技術價值被計算機體系結構領域最負盛名的學術會議 MICRO 2026 收錄。
圍繞這一點還有更細的工程分享。AI 系統基礎設施團隊負責人 Jongryool Kim 講了基於共享記憶體提升智慧體服務效能的技術:token 共享可以加速 CPU 側的 token 化,KV cache 共享則改善響應速度與資源效率;他還提出可把 token 化與即時 KV cache 重要性分析解除安裝到帶計算能力的共享記憶體上。同場的 Younghoon Min 與賓夕法尼亞州立大學教授 Kiwan Maeng 講了如何用帶計算的儲存讓差分隱私訓練更高效。AI 平臺軟體團隊的技術負責人 Juhee Lee 則分享了「把儲存當作大模型服務的一個性能層級」。另一場專題討論的主題,是多公司軟體框架與 API 在 PIM 與 PNM 上的整合與標準化需求。
展臺的另一半是產品線。eSSD 按形態分列:高效能的 PS1010 U.2、正在連續開發中的高效能 PS1110 E3.S 與大容量 PS1101 E3.S,以及支援直觸液冷(DLC)的 PEB210 E1.S 與 PEB210 M.2 2280。伺服器 DRAM 一側,容量從面向 AI 負載、官方稱為業界最大容量的 256 GB 3DS RDIMM,延伸到 96 GB 與 64 GB;此外還有 128 GB 的 DDR5 MRDIMM,以及用新形態改善功耗與空間效率的 192 GB SOCAMM2。
HBM 展區擺在正中:一側是 NVIDIA Vera Rubin 超級晶片的模型,觀眾可以自己把 HBM4 與 SOCAMM2 裝到伺服器模型上;另一側是放大一百萬倍的 HBM 模型,配一塊螢幕講解 TSV 與 Advanced MR-MUF 這兩項核心技術,中間則陳列了 HBM4E、HBM4 與 HBM3 實物,讓人一眼看出代際演進。官方給出的代際順序是 HBM、HBM2、HBM2E、HBM3、HBM3E、HBM4、HBM4E;Advanced MR-MUF 被描述為可以做到翹曲控制,把比常規薄 40% 的晶片堆疊起來而不彎曲,同時改善散熱。此外,SK 海力士還介紹了 HBF(High Bandwidth Flash):像 HBM 一樣使用 TSV 技術,把傳統儲存的大容量與高頻寬結合起來;其內部模擬顯示,需要快速響應的場景適合用 HBM,需要大容量、服務眾多使用者的場景則適合 HBF。公司對這次峰會的總結是:今年的意義在於能展示下一代記憶體方案在真實系統裡如何工作。