Meta 在 OCP 2026 亮出 102.4T 交換與乙太網路 scale-up:一櫃 72 顆加速器
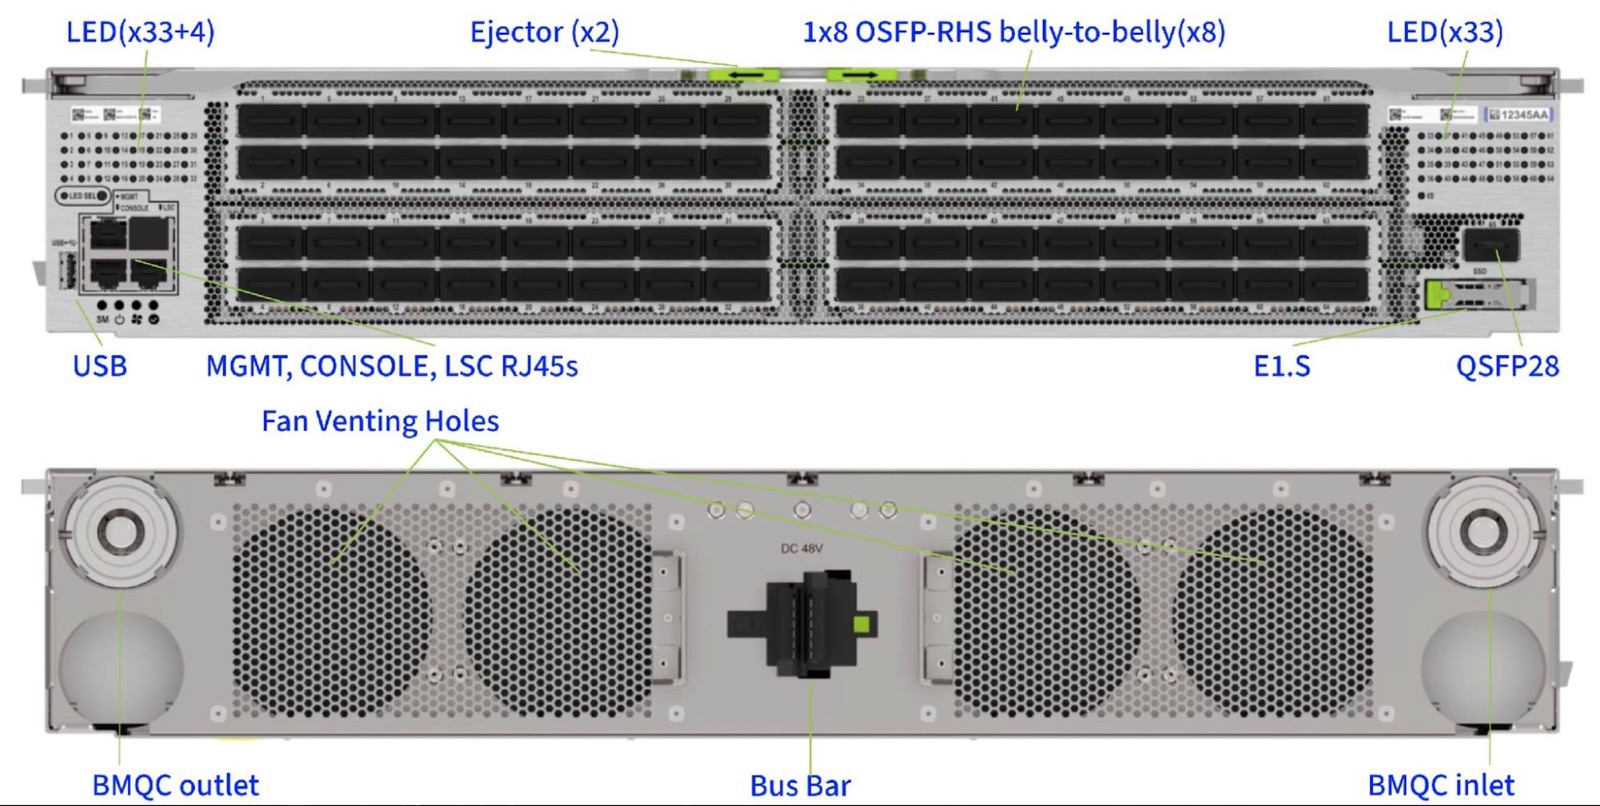
102.4T 一代與液冷網路機架
10 月 12 日,Meta 在 2026 年開放計算專案全球峰會(OCP Global Summit)上公佈了一批網路基礎設施成果,擺在最前面的兩件是硬體:公司首款液冷網路機架 IcePack,以及工作速率 102.4 Tbps 的交換刀片 IceCube。
這些硬體的服務物件是 Meta 自己的模型與智慧體:這次釋出裡點名的工作負載包括 Muse Wonder 與 Muse Spark 兩個模型,以及面向所有人的個人 AI 智慧體 Muse。換句話說,這一代網路不是為了跑分,而是為了讓自家越來越大的訓練與推理任務待在同一個集群裡。Meta 也把話說得很清楚:邀請工程師、晶片廠商、系統整合商與運營商一起,在 OCP 社群裡解決開放、高效、可持續的 AI 基礎設施問題。
IcePack 基於 OCP 的 ORV3-HPRv1 機架標準,是 Meta 第一代液冷網路機架。機架裡插的是 IceCube 交換刀片:102.4 Tbps 交換容量,提供 128 個 800G 埠的無阻塞交換能力。IceCube 有兩個版本,分別搭載博通的 Tomahawk6C 交換 ASIC 與 NVIDIA 的 Spectrum-6 交換 ASIC,兩者都執行 Meta 開源的 FBOSS 網路作業系統,並通過 OCP 的 SAI(交換機抽象介面)對接硬體。
這一代相比上一代 51.2T 平臺頻寬翻倍,同時滿足了下一代 AI 資料中心對散熱密度的要求。這也是「液冷」出現在網路裝置上的原因:當叢集走向吉瓦級,交換機必須在越來越緊的功耗與散熱包絡裡提供成倍的頻寬,單純的風冷已經不夠用。
FPF:每顆 GPU 拉八條鏈路到八臺交換機
更有意思的變化發生在拓撲上。Meta 這次介紹了 Flattened Planar Fabric(FPF),一種多平面後端組網方式;用 Meta 的話說,它從根本上改變了 GPU 接入網路的方式,也改變了這張網的控制面。
具體做法是:每顆 GPU 用八條獨立的 100G 鏈路,分別接到八臺不同的交換機上——每個平面一臺。這取代了傳統的單平面上行架構,帶來四個好處:相比單平面拓撲可以支撐更大的無阻塞 GPU 叢集;把原來的三級 Clos 壓平成兩級 Clos,減少一層交換機,從而減少跳數、降低延遲與基礎設施成本;負載均衡從交換機前移到網絡卡,由網絡卡硬體把每個報文噴灑到八個平面上;控制面同時覆蓋交換機與主機,主機據此把流量從故障平面上引開。
這項工作與 NVIDIA 緊密合作完成,跑在 Meta 自己的基礎設施裡,借用了 NVIDIA Spectrum-X 的多平面創新,以確保在各類故障與運維生命週期場景下仍有高效能。Meta 還把經驗分享給雲夥伴,推動多平面組網在合作伙伴側落地。這不只是技術問題:Meta 的算力缺口無法單靠自建機房填滿,土建以年計、需求變化以月計,因此必須同時使用租賃設施與公有云容量。而要讓公有云裡的 GPU 和自建機房裡的 GPU 表現一致,網路必須被標準化。
跨區域的一層是 BAG(後端聚合)。它是乙太網路為基礎的集中式超級脊,把多個脊層組網連成跨越樓宇、園區與區域的巨型叢集,工作在拍位元量級——兩個區域之間的 BAG 互聯容量可達每秒數十拍位元。Meta 給出的規模座標是:Prometheus 在 2026 年約 1 吉瓦,Hyperion 則向 5 吉瓦擴充套件。距離在這裡變成設計約束:無損乙太網路所需的緩衝餘量正比於線纜長度,鏈路拉到幾十公里後,緩衝管理就從調參問題變成首要問題。FBOSS 的做法是在現場測量真實線纜長度——通過測量無擁塞佇列上探測流量的往返距離來推導,再按測量值分配餘量。
用乙太網路做 scale-up
scale-up 指的是機架或 pod 內加速器之間那種高頻寬、超低延遲的互聯,歷來依賴各傢俬有技術。Meta 這次要證明乙太網路也能幹這件事:它推出的是一臺叫 Tahan 的乙太網路 scale-up 交換機,專為 Meta 自家的 MTIA 300 訓練加速器設計,基於博通 51.2 Tbps 的 Tomahawk 5 ASIC,總容量 64 個 800G 埠,其中一半通過背板為加速器提供 scale-up 連線;四臺 Tahan 以無阻塞拓撲互聯 16 顆加速器,平均到每顆加速器是 6.4 Tbps。更關鍵的是,Tahan 複用了與 scale-out 網路完全相同的無損 RoCE 傳輸(路由化 IPv6、PFC 與為 AI 調優的 QoS),把兩張網統一在 FBOSS 之下。
下一代方案已經畫好:一塊 216 個 400G 埠的 scale-up 刀片,基於 102.4 Tbps 的博通 Tomahawk6C,八臺這樣的交換機互聯一櫃 72 顆加速器,密度相比這一代顯著提升。再往後的一代計劃採用 OCP 的 ESUN(Ethernet for Scale-Up Networking)作為 scale-up 資料面。ESUN 是 Meta 去年在 OCP 內發起的倡議,參與者包括 AMD、Arista、ARM、博通、思科、HPE、Marvell、微軟與 NVIDIA;1.0 版網路運營商需求基礎規範已於今年早些時候釋出,下一版 1.1 將處理交換機方案檔位與報文間隔壓縮等新特性。
OSPA 與 MetaRoCE:再往上標準化一層
Meta 還拉上微軟與阿里巴巴共同牽頭一項新的 OCP 倡議:Open Switch Platform Architecture(OSPA)。邏輯是:SAI 已經讓交換機的資料面軟體可以在不同晶片間遷移,但它下面的交換機平臺層仍然是私有且碎片化的,每上一個新硬體平臺都要重複數月的定製工程。OSPA 要統一的是電源管理與時序、感測器與環境控制(含散熱與風扇)、硬體資產管理與裝置列舉、帶外硬體介面(管理網口、序列埠、USB、指示燈)、韌體維護更新,以及平臺故障診斷。
傳輸層方面,Meta 宣佈開源 MetaRoCE 的實現。這是一個為 AI 叢集網路最佳化的 RDMA 傳輸協議,提供分散式 AI 訓練所需的擁塞控制與可靠性語義,專門針對大規模乙太網路上的集合通訊流量形態設計。此外,Meta 還用 FBOSS 在區域骨幹網上部署了基於 IPv6 的分段路由(SRv6),執行在基於思科 SiliconOne 的開放淺緩衝交換機平臺上。
把這些拼在一起,Meta 的意圖就清楚了:它想讓 AI 基礎設施從交換機、機架到傳輸協議全部建立在開放標準之上,而自己既當最大使用者,也當標準的主要貢獻者。這套路線能不能被更大的生態接受,還取決於其他公司是否願意為 ESUN、OSPA 與 MetaRoCE 投入工程資源——這是標準化的老問題,也是 Meta 這次把「邀請」寫進發布稿的原因。