NVIDIA「Vera Rubin」MLPerf 首秀:推理吞吐最高達 GB300 的 3.7 倍
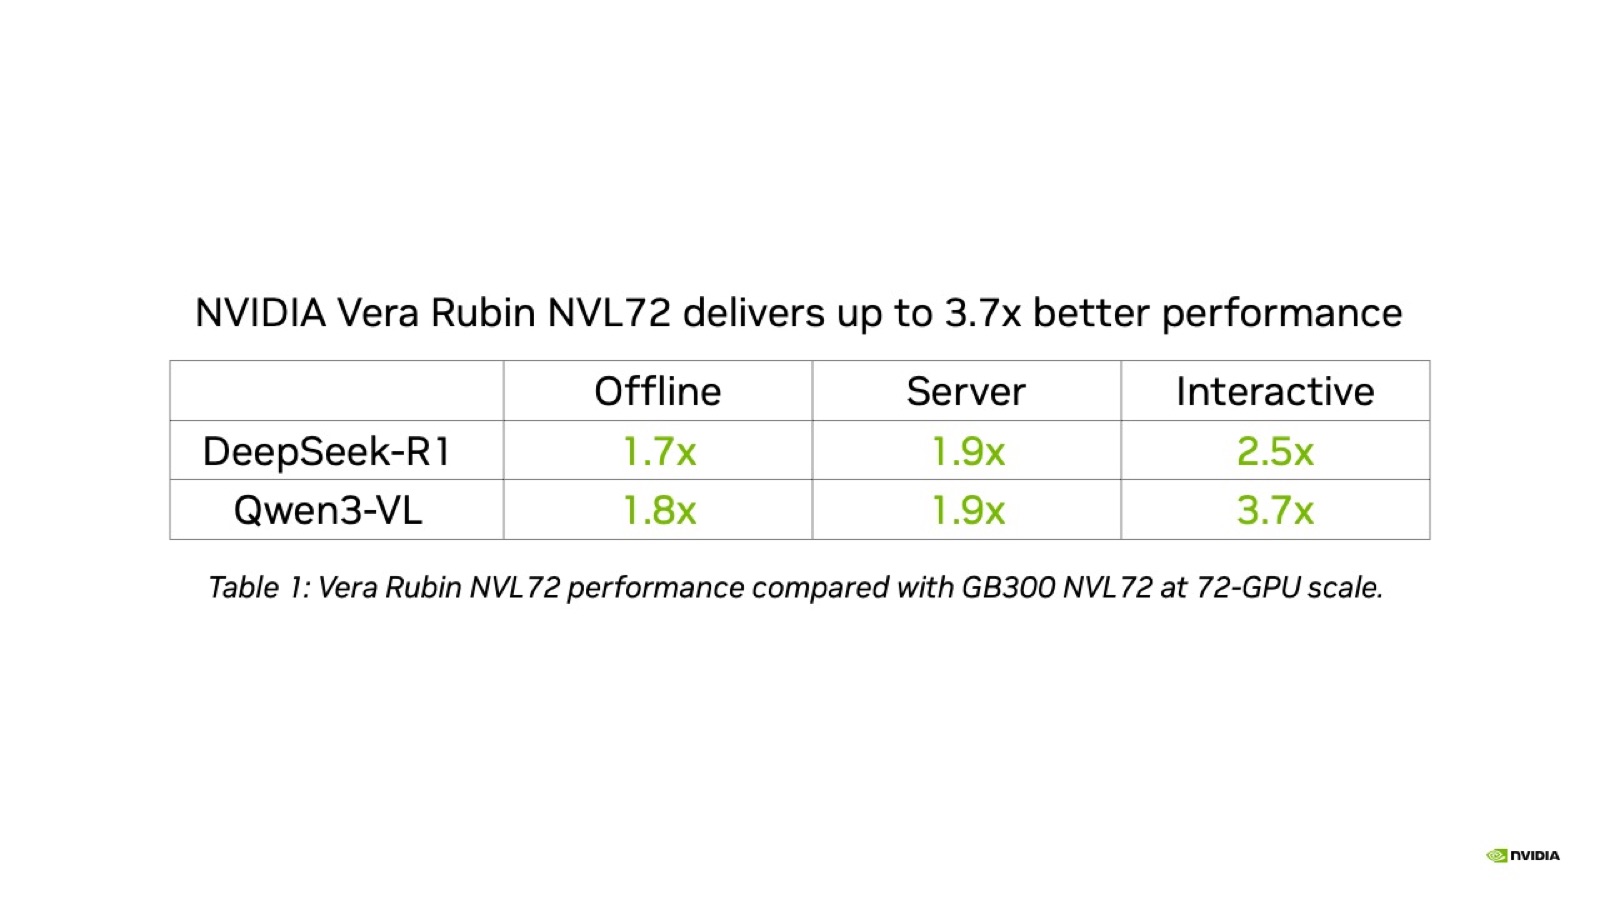
預覽提交裡的三個數字
9 月 16 日,MLPerf Inference v6.1 的結果公佈,NVIDIA 的下一代機架級平臺 Vera Rubin NVL72 第一次出現在這份榜單上——以「預覽提交」的形式。NVIDIA 在其官方部落格裡給出的結論很直接:這套系統在 Qwen3-VL 上的吞吐量最高達到上一代 GB300 NVL72 的 3.7 倍,在 DeepSeek-R1 上最高達到 2.5 倍。MLCommons 的推理基準歷來是各家加速器同場比試的公開場地,一次「首秀即領先」的提交,等於把下一代平臺的量產節奏提前亮給了客戶。
需要先分清「預覽提交」的含義。NVIDIA 這次只選了兩個模型參賽:DeepSeek-R1 與 Qwen3-VL,並明確說這是預覽結果,成績取自 mlcommons.org 上公佈的條目。它沒有覆蓋 MLPerf 推理套件的全部負載,因此 3.7 倍與 2.5 倍是真實測得的數字,但它描述的是一部分場景,而不是整張成績單;NVIDIA 自己也把「隨軟體最佳化繼續提升」寫進了結論。圖表下方註明了資料出處:結果取自 9 月 16 日 mlcommons.org 上公開的條目,編號為 6.1-0106 與 6.1-0074。
具體到場景維度,差距並不均勻。官方給出的對比表顯示,在 72 卡同規模下,DeepSeek-R1 的離線、伺服器、互動三種場景相對 GB300 NVL72 分別是 1.7 倍、1.9 倍和 2.5 倍;Qwen3-VL 則是 1.8 倍、1.9 倍和 3.7 倍。離線場景衡量吞吐上限,互動場景衡量響應速度——越是要求低延遲的場景,新一代平臺的相對優勢越大。同一張表裡,兩個模型的最大倍數都出現在互動場景,最小值都出現在離線場景,這個分佈本身也說明新平臺先在延遲敏感型負載上兌現了優勢。
是什麼撐起了這些倍數
兩個模型走的軟體棧也不相同:Qwen3-VL 用的是 vLLM 加上 NVIDIA 開源的推理框架 Dynamo,DeepSeek-R1 用的是 TensorRT-LLM。NVIDIA 把成績歸因於硬體與軟體的聯合設計:增強的 Tensor Core 與 Transformer Engine 同時加速預填充和解碼兩個階段,而 NVFP4 這類低精度格式壓縮了模型權重、注意力與 KV cache 的視訊記憶體佔用,從而在不明顯損失輸出質量的前提下提高吞吐。
另一個被反覆提到的技術是「分離式服務」:把預填充與解碼拆到不同的資源上執行,再配合面向混合專家(MoE)層的大規模專家並行。DeepSeek-R1 與 Qwen3-VL 都屬於 MoE 架構,專家並行做得好不好,直接決定這類模型能不能跑滿機器。
NVIDIA 在部落格裡給推理算了一筆賬:決定 AI 推理經濟性的槓桿有三個——系統性能、擴充套件效率與軟體迭代速度。效能高意味著每臺機器產出更多 token,也就是更多收入;擴充套件效率高意味著加機器能換來等比例的吞吐,服務同樣多使用者所需的資源更少;持續最佳化則意味著同一批硬體能在生命週期裡持續增值。
這三個槓桿對應三個具體問題:這臺機器值不值得買、多買幾臺能不能線性變快、以及同一批機器明年還夠不夠用。「平臺通用性」被放在這三者的底層。同一套基礎設施既要跑訓練也要跑推理,既要跑推薦也要跑推理型的大模型,既要處理語言也要處理影片——只有在這些負載之間自由切換,機器的利用率才能保持在高位。這也是 NVIDIA 每年更新一代平臺架構的理由:硬體節奏固定下來,客戶才敢按年度規劃資本開支。
從 72 卡到 288 卡:99% 的擴充套件效率
除了新一代平臺的絕對效能,這輪提交裡還有一個容易被忽略的數字:GB300 NVL72 在 DeepSeek-R1 的離線場景下,從單機架 72 顆 GPU 擴到四機架 288 顆 GPU,擴充套件效率達到 99%。也就是說,硬體翻了四倍,吞吐量幾乎線性增長。
這個數字為什麼重要?因為堆 GPU 並不會自動帶來成比例的吞吐。如果 GPU 數量翻倍而吞吐只漲個位數百分比,基礎設施成本就會遠遠跑在效能回報前面。要做到近線性擴充套件,機架內的高速縱向互連、機架間網路與請求編排必須同步跟上。NVIDIA 給出的底氣是第六代 NVLink 與 NVLink Switch:官方稱其報文速率是通用乙太網路的 10 倍、延遲低至三分之一。NVIDIA 還提到,雲服務商 Nebius 同樣提交了 Vera Rubin NVL72 的預覽結果並給出了不錯的成績,說明這套平臺已經開始被外部納入測試。
影片生成也出現在這輪結果裡。GB300 NVL72 在 WAN 2.2 文生影片基準上做到每秒 0.65 個 720p 影片、單條 5.7 秒——相比單節點,吞吐高 9 倍、延遲低 7.5 倍。
軟體時鐘與硬體節奏
同一套硬體在一年之內能快多少?NVIDIA 給了一個可比的答案:在 v6.1 這輪提交中,GB300 NVL72 跑 Qwen3-VL 的成績比 v6.0 最多提升了 1.6 倍,來源是更低的 KV cache 精度、更多的運算元融合、更優的 kernel,以及 vLLM 與 Dynamo 支撐的分離式服務。
提交截止之後,最佳化還在繼續。NVIDIA 同時披露了一些尚未經過 MLCommons 驗證的提交後結果,覆蓋 GPT-OSS-120B 與 DLRMv3,並稱還有進一步提升。這類數字要謹慎對待——它們沒有第三方審計,但仍然說明了一個趨勢:在這條產品線上,軟體版本帶來的收益可以和一個硬體代際相當。
邊緣側同樣有更新。NVIDIA 用 Jetson AGX Thor 提交了基於 TensorRT Edge-LLM 的成績,參加的是新引入的 Edge-Agentic 基準,模型為 Qwen3.6-27B。這輪共有 19 家合作伙伴參與提交,其中八家提交的是多節點 Blackwell NVL72 系統,名單包括華碩、Azure、思科、CoreWeave、戴爾、富士通、HPE、Lambda、Nebius、Oracle 雲基礎設施與超微等。
還有一個指標值得一提:在 SemiAnalysis 的 AgentX 基準的預覽測試中,NVIDIA 稱 Vera Rubin NVL72 的效能是 GB300 NVL72 的 30 倍。該數字來自廠商自測,但指向的問題很實在——當 AI 從「一問一答」變成多步推理、規劃與執行的智慧體,傳統吞吐基準就不再夠用,MLPerf 也將引入 Endpoints 基準來標準化這類負載的測量。對買方來說,真正的判斷標準仍只有一個:在自己的模型和自己的負載上,每 token 的成本降到多少。