安霸釋出 X7:首款獨立 AI 加速器,給存量 Arm 與 x86 裝置補算力
把 AI 裝進已經賣出十年、還要再用十年的裝置
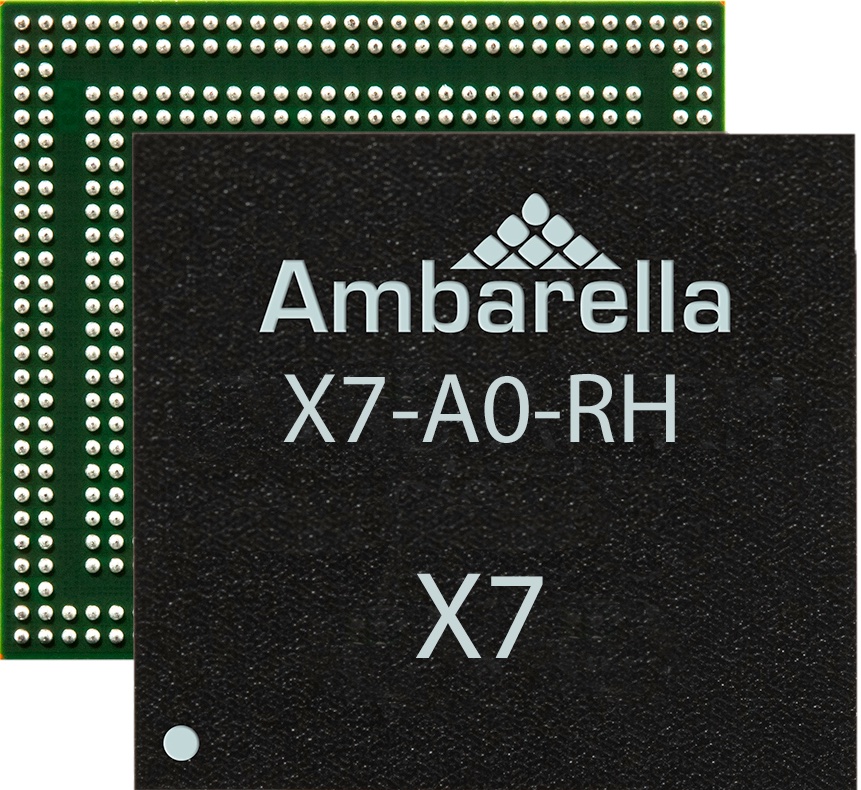
9 月 15 日,安霸(Ambarella,NASDAQ: AMBA)在聖克拉拉釋出 X7 邊緣 AI 加速器,這是公司第一款獨立的 CVflow AI 加速晶片。它的定位不是主控,而是 Arm 與 x86 主處理器的 AI 協處理器:把它插進系統,就能增加或擴充套件 AI 能力,而不必重新設計底層平臺。
安霸在公告裡描述了一個很具體的市場:現場已經裝出去的攝像頭、閘道器和工業控制器,很多隻有有限的 AI 能力,或者乾脆沒有,但它們還有多年的服役壽命。這些裝置的所有者與運營方現在開始要求 AI 功能,而這些功能在硬體被設計出來的年代並不存在。安霸的說法是,實物世界裡這樣的系統有數百萬臺。X7 面向兩類人:一類是對這批存量裝置負責的 OEM 與系統整合商,另一類是在決定投入下一代重設計之前先驗證新 AI 功能的團隊。
這裡有一個容易被忽略的經濟學。工業與安防裝置的更新週期通常遠長於消費電子,一套裝在貨架、產線或路口的系統,生命週期往往超過十年。裝置一旦裝滿牆、接好線纜、做完驗收,整機替換的成本就不只是硬體本身,還包括停機、施工與重新認證。因此「在不換主機的前提下加一塊加速器」,在商業上比「換一代 SoC」要容易說服決策者得多。
2 到 5 瓦:決定 AI 功能能不能落地的硬約束
安霸把限制條件說得相當直白:一臺曾經只跑單個檢測模型的攝像頭或檢測系統,現在要同時跑好幾個,而且常常要組合傳統計算機視覺、視覺語言模型與自然語言介面。這些 AI 功能能不能在一臺嵌入式產品裡跑起來,取決於一些沒有彈性的因素——功耗、散熱餘量、延遲與系統成本。
X7 給出的答案是 2 到 5 瓦的功耗區間。按公告的說法,這是在其當前客戶設計中實測的工作區間,好處是加速器可以落在平臺原有的能耗與散熱約束之內,不用改變機殼尺寸,也不必顯著抬高物料清單成本。這一點非常重要:對一臺已經定型的產品來說,機殼、風扇與供電往往是最難動的部分,任何超過原有熱設計功耗的加速器都必須伴隨一次結構重做,那樣「免重設計」的前提就消失了。
算力型別上,X7 支援 CNN、視覺 Transformer、多模態 Transformer 以及混合網路,用的正是安霸整合在自家 SoC 裡的同一套 CVflow 計算機視覺與深度學習處理器。從卷積網路到 Transformer 再到多模態,模型結構在近幾年發生了明顯位移,邊緣裝置能不能跟上,取決於加速器對算子集合與記憶體頻寬的支援是否覆蓋新架構——這也是為什麼廠商在宣傳加速器時,通常會把「支援哪些模型家族」放在算力數字前面。
接入方式與軟體連續性
X7 是一顆與主機無關的加速器:通過單通道 PCIe Gen 3 或者 USB 3.2 連線到主機,在系統裡表現為一個標準的 PCIe 裝置。主機也可以是安霸自家的 SoC,因此已經在出貨安霸方案產品的客戶,也有一條在不動板子的前提下提升某個負載 AI 效能的路徑。
軟體側,X7 由 Cooper 開發者平臺支援——這是服務安霸所有 AI SoC 的同一套環境,包括編譯器、量化與效能分析工具、C++ 與 Python 執行時 API,以及多模型流水線所需的排程與記憶體管理。Cooper 模型花園(Cooper Model Garden)裡的模型同樣被設計為可以在 X7 上執行,配套的文件、示例程式碼與工程支援與安霸 SoC 客戶一致。
更關鍵的是「不用重寫」這一點。因為 X7 與安霸 SoC 產品線共享 CVflow 架構,為某顆 SoC 構建的模型或感知流水線,被設計成可以直接搬到 X7 上,路徑與產品線遷移到下一代整合 SoC 時相同。CVflow 已經演進到第三代,安霸自 2015 年起就在矽片裡做神經網路處理,按其口徑,目前部署在外的 AI 處理器超過 5000 萬顆。
XCalibur 參考設計與市場路徑
配套的參考設計與開發平臺叫 XCalibur:一張標準 2280 規格的 M.2 卡,帶 LPDDR5 記憶體,PCIe 吞吐超過 840 MB/s,可以同時處理多路影片流與多個 AI 模型。安霸表示打算把完整的 XCalibur 設計檔案提供給客戶,讓 OEM 或 ODM 可以在同一份設計上從評估走到量產模組——這是把「樣片」變成「可交付產品」的常見做法,也決定了客戶匯入的時間成本。
目標市場列得相當寬:零售與實體安全、工業檢測與製造、移動機器人與無人機、智慧交通與關鍵基礎設施,以及自助終端、POS、閘道器、本地 AI 裝置這類企業邊緣系統。安霸特別提到,X7 並不侷限於攝像頭,它可以處理多種數字與物理資料模態,因此適合邊緣基礎設施推理系統,也適合機器人這類端點裝置。銷售渠道除了直銷,還包括 9 月 3 日宣佈的 Capgemini 與 Macnica 合作渠道:前者面向大型企業的複雜部署,後者覆蓋美洲與 EMEA 的中小客戶、獨立軟體供應商、OEM、ODM 與系統整合商。
可獲得性方面,X7 目前處於樣片階段,XCalibur 評估套件面向合格客戶提供。安霸在 9 月 15 日至 17 日於聖克拉拉會議中心舉行的 AI Infrastructure Summit 上進一步介紹了 X7。
公司總裁兼執行長 Fermi Wang 的說法是:很多客戶的現場系統,是在終端使用者如今期待的 AI 負載還不可能實現的年代設計的;X7 把執行在超過 5000 萬顆安霸 AI SoC 裡的第三代 CVflow 引擎,帶到了客戶已經大規模部署的平臺上。他同時給出了邊界——當團隊圍繞 AI 設計整個系統時,整合式 SoC 仍是最強選擇;X7 覆蓋的是其餘場景:平臺已經在現場,或者仍在做原型。
保持懷疑同樣有必要。所有功耗、吞吐與算力相關的數字都來自安霸自己的客戶設計,沒有第三方基準;「5000 萬顆」是累計出貨量而非當前活躍量;樣片階段的器件到量產還有工程驗證與良率爬坡的距離。真正值得觀察的是兩件事:這塊卡最終能賣出多少片進入存量裝置,以及當主機是別人的 x86 平臺時,軟體棧的移植是否真的像公告裡那樣平滑。