Figure「Helix 2.5」:人形機器人零樣本泛化到 30 個陌生家庭
一件人類習以為常、機器人做不到的事
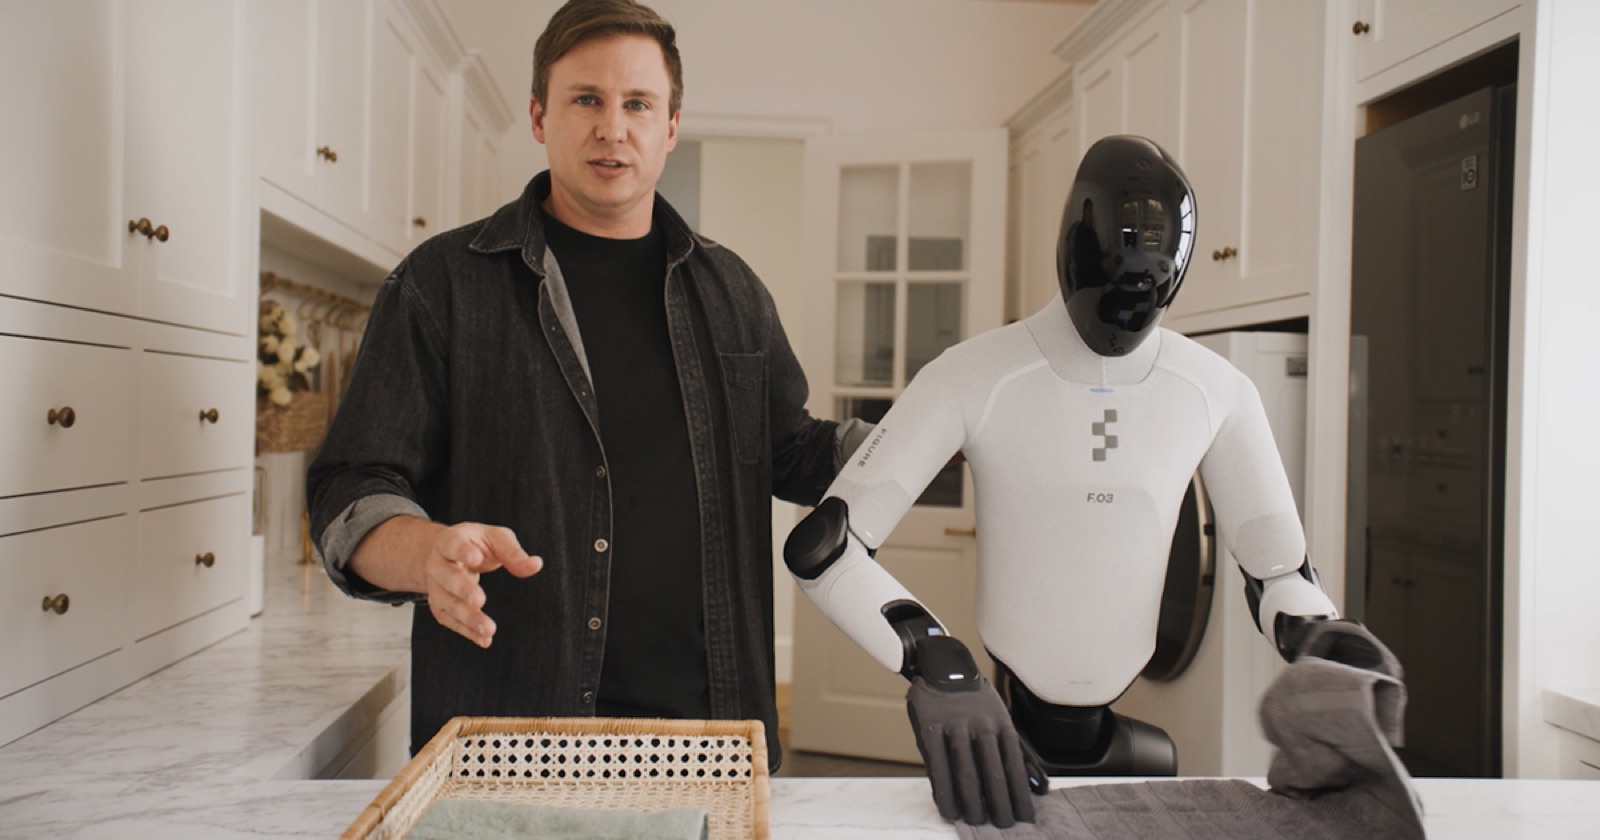
9 月 17 日,Figure 釋出新一代人形機器人控制模型 Helix 2.5,公司稱這是「我們構建過的最先進的神經網路」。它要回答的問題聽上去很樸素:一個人走進陌生的家,可以立刻開始幹活——不需要因為床的高度不同而重新學一遍鋪床,也不會因為傢俱換了樣式就不知道怎麼收拾房間。而機器人此前不是這樣,它們是「在哪裡幹活,就在哪裡學」,一個地方一個地方地學。
上一代 Helix 02 已經展示過神經策略能協調人形的整個身體完成長程任務:解除安裝洗碗機、連續 200 小時自主執行物流作業。但這些系統的訓練資料,恰恰採自它們將來要工作的那些場所。Helix 2.5 想越過這條線:用一個在人類行為資料集 Index 上預訓練出來的基礎模型,去支撐從未到過的家。
從 9% 到 56%:一次只改一個變數
Figure 從同一個 Index 預訓練底座上派生出三種行為:收拾客廳、疊毛巾、鋪床,然後帶著機器人走進 30 個灣區住宅。三類任務合在一起,同時考驗感知、行走、操作、雙手協同與全身控制:收拾房間要求把散落的 13 到 15 件玩具全部拿起放進籃子,疊毛巾要求把毛巾摺好放進籃子,鋪床則要求兩個枕頭與被子兩個角都到位、被子拉平。
「零樣本」在這裡有嚴格定義:評估所用的每一個家庭、每一件被操作的物體,都從未出現在任務說明資料裡;機器人使用的是每戶人家現成的沙發、床和摺疊檯面。評估物體在實驗開始前就被單獨封存,先由 AI 模型、再由人工複核確認它們沒有進入任務說明資料。全部 30 個家庭共用同一個固定檢查點,權重不針對任何家庭或物體做調整,檢查點的挑選也不參考任何評估回合的表現。
最關鍵的對照實驗只有一個變數。Figure 用完全相同的任務說明資料訓練兩個策略——這份資料裡同樣不含評估家庭與評估物體:一個從隨機權重開始訓練,另一個從 Index 預訓練的 Helix 2.5 初始化。架構、最佳化器、超引數、下游資料與評估方式全部固定,唯一差別就是有沒有 Index 預訓練。
盲測結果:從零開始訓練的策略零樣本成功率 9%,Index 預訓練的策略 56%,提升超過六倍。Figure 的結論是,Helix 2.5 的零樣本能力大部分來自 Index 預訓練,而不是任務說明資料本身。還有一個能說明預訓練寬度的數字:在體量龐大的 Index 預訓練集裡,任何一個評估任務所佔的比例都不超過 1.90%。起點也不同——Helix 02 是從一個預訓練的視覺語言模型出發,Helix 2.5 則是完全從隨機初始化、在 Index 上預訓練出來的。
成功口徑同樣嚴格:任務必須整段完成才算成功——每一件玩具都進筐、每一條毛巾都摺好、整張床都鋪完,Figure 不給部分得分。評分細則在評估開始前就已固定:每件玩具限時 1 分鐘,超時即中止該回合;每條毛巾限時 3 分鐘,並按四個角能否在 1 英寸內對齊分 A、B、C 三檔;枕頭必須被拿起並放到床的上三分之一,朝向偏差小於 15 度算好、小於 45 度算差;被子兩側都要被抓起、兩個角都要到達床的上三分之一,兩角相差 6 英寸以內算好、6 到 12 英寸算差。任何一回合只要需要人工介入以保證安全,該回合就中止並記為失敗。
成本減半、自我糾錯與一條縮放曲線
預訓練是否改變了「指定一個新行為需要多少機器人資料」?Figure 把 Helix 2.5 與一個執行同一任務的舊 Helix 02 策略做了對比。舊策略的訓練資料直接採自它被評估的那個環境,而 Helix 2.5 只用了它一半的適配資料就達到相當的成功率——還是跨 30 個陌生家庭零樣本完成的。用 Figure 的話說:行為規格的成本減半,泛化範圍擴大 30 倍。
預訓練還帶出一個定性變化:全身自我糾錯。長程任務、尤其在不熟悉的環境裡,機器人難免做錯一步;Helix 2.5 會退回去重新對位、改變站姿,甚至繞到床的另一側把沒摺好的角重新處理。Figure 把這種「從錯誤中恢復並繼續推進」的能力,視為 Index 預訓練的結果,而不是專門訓練出來的技巧。
縮放律曾經改變語言模型的開發方式:下一詞預測的誤差會隨資料與算力增加而可預測地下降,於是小規模實驗可以用來預測大規模訓練的結果。Figure 想知道,人類經驗到機器人的遷移是否也遵守類似規律。他們用 Index 的巢狀子集訓練了四個模型,預訓練資料量跨度 8 倍,模型規模與下游訓練方式保持不變,每個模型都用同一份任務資料微調、在同一份留出的動作預測損失上評估。結果是每把 Index 資料翻一倍,損失就按預期下降;更精確的是可預測性——只用規模較小的幾次執行,就能在訓練開始前把最大一次執行的測試損失預測到小數點後四位,預測誤差只相當於整個 8 倍資料區間變化的 0.54%。Figure 稱這是首個在人形機器人上測出的人到機器人遷移縮放律,它衡量的是資料這一維的縮放。
為什麼「家」是更難的考場
機器人泛化研究大多發生在為機器讓步的環境裡:在桌面上工作的機械臂有固定工作空間,輪式機器人需要足夠開闊的地面容納底盤轉身。住宅不會這樣配合。人形必須作為任務的一部分在住宅裡移動,在侷促、雜亂的動線裡擺正身體,才看得見、夠得到、操作得了。於是任務變成全身問題:感知、行走與操作無法分開求解。零樣本又把難度推高一層——房間、佈局、物體在訓練裡都沒見過,到現場也沒有適應期,機器人只能憑已經學到的東西把完整的感知與控制問題解出來,而在這種複雜度上的人形自主行為即便在熟悉環境中也屬罕見。
Index 的構建方式值得一提。Figure 用兩種嵌入來刻畫其中的任務:對每個片段做影片嵌入,再用視覺語言模型對每段的活動與物體描述做文本嵌入,把兩者分別聚類成巢狀的語義層級,然後衡量任意一份資料或訓練快照在這些語義組上的小時數分佈。正是這種廣譜的預訓練,才支撐得起任意行為的微調,也是 Figure 說「首次在這一規模上做到零樣本全身泛化」的依據。
該保留的懷疑也不能省。這是公司自測的結果,不是獨立復現的基準,Figure 自己也強調通用人形機器人遠未被解決;所謂零樣本,限定的是評估環境與被操作的物體,三個任務本身仍由在別處採集的微調資料來指定。56% 意味著接近一半的整段任務沒有完成——對家庭場景來說,這個數字指明瞭方向,但還談不上可用性。
Figure 給出的下一步仍是大模型那套熟悉的配方:在預訓練裡廣泛地學,把行為一次性指定好,到部署時再泛化。他們披露 Index 正以每秒約 35 分鐘人類經驗的速度增長,並已承諾 35 億美元算力用於訓練 Helix。一年前,Figure 的判斷是機器人行業在模型規模、算力和資料上差了好幾個數量級,Index 與 Helix 2.5 是他們給出的答卷。