樹莓派 AI HAT+ 2 開賣:40 TOPS,本地跑生成式模型
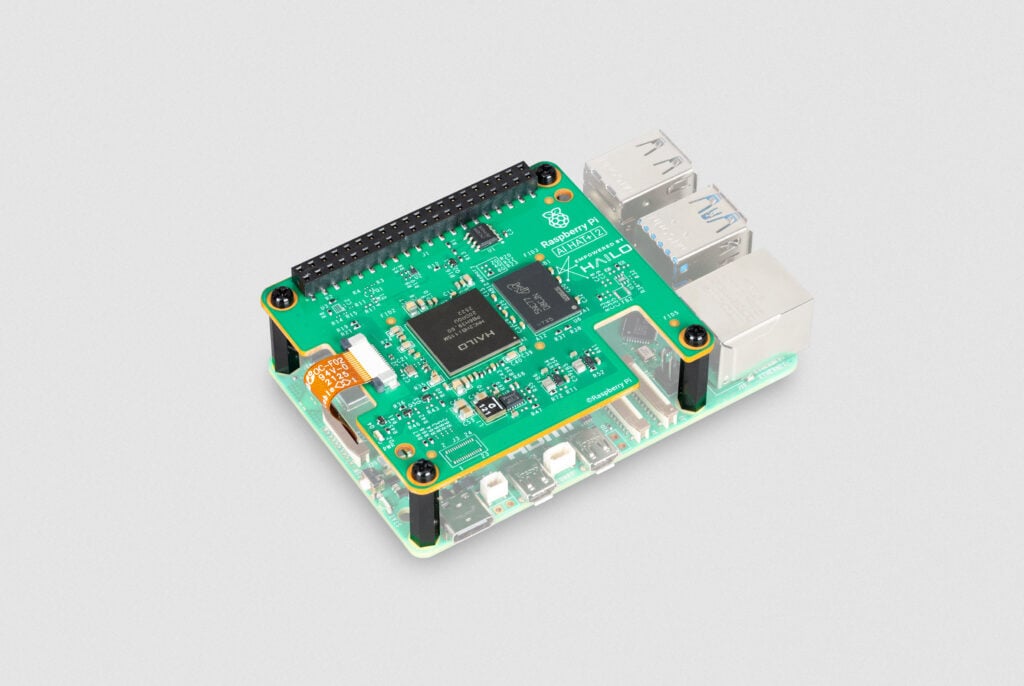
1 月 15 日,樹莓派發布 AI HAT+ 2,面向 Raspberry Pi 5。它搭載 Hailo-10H 加速器,算力最高 40 TOPS,板載 8 GB LPDDR4X 專用記憶體,售價 130 美元,釋出即開賣。與常見的「先發布、後到貨」不同,這塊板子當天就可以下單。
與前代最大的差別在於能跑什麼:除了計算機視覺,AI HAT+ 2 可以在本地執行語言模型與多模態(VLM)工作負載,官方把它稱為第一款為填補生成式 AI 空白而設計的 AI 產品。換句話說,它的目標不是讓樹莓派看得更清楚,而是讓樹莓派能對話、能寫程式碼、能看著畫面說出一段描述。
從產品線看,這也是樹莓派 AI 策略的一次轉向。一年前推出的初代 AI HAT+ 走的是「把視覺推理做快」的路線,面向攝像頭與機器視覺;而 AI HAT+ 2 把目標改成了「把模型跑起來」——同一個硬體形態,服務的是完全不同的應用假設。
40 TOPS 與 8 GB:兩個數字的分量
先說 40 TOPS。TOPS 指每秒萬億次運算,是加速器算力最常用的口徑;但同一個數字在不同精度下的含金量並不相同——AI HAT+ 2 的 40 TOPS 是 INT4 精度下的數值。整數量化位寬越低,單位面積能塞進的算力越多,代價是精度損失,因此邊緣晶片的算力指標必須連著精度一起看,只比 TOPS 很容易得出錯誤結論。
第二個數字可能更關鍵:8 GB 專用記憶體。更早的 AI HAT+ 提供 13 或 26 TOPS,主要面向視覺任務,沒有這樣一塊獨立記憶體;而跑語言模型時,權重與 KV 快取都要佔記憶體,板載記憶體的大小往往比峰值算力更早成為瓶頸。模型能不能裝下、上下文能開多長,本質上由這塊記憶體決定,這也解釋了為什麼它能第一次談「生成式」。換句話說,算力決定了能不能跑,記憶體決定了能跑多大——後者往往才是決定體驗的那一個。
開箱能跑什麼
釋出時可安裝的語言模型包括 DeepSeek-R1-Distill(15 億引數)、Llama3.2(10 億)、Qwen2.5-Coder(15 億)、Qwen2.5-Instruct(15 億)與 Qwen2(15 億)。更多、更大的模型正在準備中,預計在釋出後不久提供。從清單可以看出一個規律:引數規模集中在 10 億到 15 億之間,正好與板載記憶體的容量相稱。
使用方式上,官方示例採用 hailo-ollama 作為推理後端,搭配 Open WebUI 前端,在瀏覽器裡提供熟悉的對話介面,全部推理都在本地完成。示例覆蓋了常識問答、程式碼任務、中英翻譯,以及用 VLM 描述攝像頭畫面——最後一項把相機與語言模型串了起來,也最能體現這塊板子與純視覺加速器的區別。從工程角度看,這些示例的價值不在演示效果,而在於把「部署鏈路」跑通:模型怎麼裝、後端怎麼起、前端怎麼接,都能照著復現。
不過要擺正預期。雲端主流大模型動輒 5000 億到 2 萬億引數,而板載記憶體能裝下的邊緣模型通常在 10 億到 70 億引數之間。這類小模型的目標不是復刻大模型的知識面,而是在受限資料集內可靠工作——換言之,領域內聽話,比什麼都懂更現實。這也是所有邊緣 AI 方案共同的前提:先接受模型規模的上限,再在這個上限裡尋找最有價值的任務。
能改、能調:LoRA 與相機鏈路
彌補差距的辦法是微調。視覺模型可以用貼合場景的影像資料集重新訓練;語言模型這邊,AI HAT+ 2 支援基於 LoRA(低秩適配)的微調——只訓練一小部分適配引數、主體權重保持凍結,再把介面卡編譯進模型。官方提供的 Hailo Dataflow Compiler 用來做這類編譯工作,也就是說,「先通用、再專用」這條路是通的。對工業與教育場景來說,這一點可能比模型清單更重要:能改,才談得上適配自己的資料。
對已經在用初代 AI HAT+ 的開發者,過渡基本平滑:視覺模型(如 Yolo 目標識別、姿態估計、場景分割)的表現與前代 26 TOPS 版本大致相當,靠的正是板載記憶體;與相機軟體棧(libcamera、rpicam-apps、Picamera2)的整合也保持一致。此外,該板通過 PCIe 連線,因此面向 Raspberry Pi 5。這也意味著它無法插到更早的樹莓派上——介面決定了兼容範圍,而不是軟體。
它與 MCU 級 NPU 不在同一檔
定位上需要說清:Pi 加 AI HAT 屬於「Linux 單板機 + 外掛 NPU」。它與 MCU 級 NPU(例如 STM32N6、MCX N947 這類帶加速器的微控制器)不在同一檔——功耗、啟動複雜度與時延都更高,但能跑的模型大得多。選型的分界線其實很清楚:如果任務要求毫秒級啟動、微安級待機,就該去 MCU 那邊;如果要跑語言模型、要接螢幕與網路,單板機加加速器才現實。
HAT 這個形態本身也值得一提:它以疊加板的方式接在主機板之上,藉助既有的連線與供電,把新增功能做成可以隨時加裝的模組。對愛好者與教育場景,這比重新設計一整塊板子友好得多,也讓升級路徑變得簡單——主機板不動,算力可以換。對照同期的其他方案,它的價值更多在於「可獲得的算力」,而不是「最高的算力」。
價格與門檻也值得說一句。130 美元對個人開發者不算小數目,但相對於此前為了跑同類模型所需的顯示卡與整機,它把門檻壓到了「再加一塊擴充套件板」的量級。這件事本身,比任何單項引數都更能解釋它受關注的原因。
這件事的意義在於可及性:入門級的邊緣生成式 AI 現在能在一塊愛好者熟悉的單板機上完成,本地 LLM 一體板開始進入愛好者生態。它不會替代雲端模型,但它把「不聯網、不上傳、不訂閱」這條路線變得可負擔——資料不出裝置,也就談不上上傳。當然,它也有明確的邊界:模型規模受限、併發能力有限,還需要一塊 Raspberry Pi 5 作為底座,這些都不適合用「小而全」的期待去看它。